CSVだけでは型と関係を共有できない
CSVは、表計算ソフト、Python、データベース、CADの間で使いやすい交換形式です。しかし、CSVファイルだけを渡しても、各cellが整数か文字列か、空欄をNULLとみなすか、どの列が主キーかは伝わりません。
たとえば部品番号0012を数値として読むと先頭ゼロが消えます。質量12.50を浮動小数点数へ変換すれば、元の桁表現は残りません。material_idが材料マスターに存在しなくても、CSVの構文自体は正しいままです。
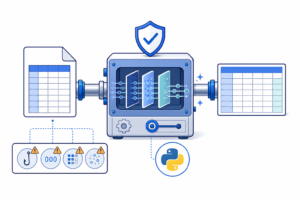
CSVW(CSV on the Web)は、CSVとは別のJSONメタデータに、列名、datatype、NULL表現、必須条件、主キー、外部キーなどを記述するW3Cの仕組みです。CSVの手軽さを残しながら、読み手の推測を機械可読な契約へ置き換えられます。
CSVWで解決できること
CSVWのメタデータは、table、row、column、cellを注釈するための情報です。W3C仕様では、メタデータを使って検証、変換、表示、検索を行うモデルが定義されています。
実務上は、次の曖昧さを減らせます。
- headerと内部field名の対応
- string、integer、decimal、date、booleanなどの型
- 必須cellとNULLを許すcellの区別
- 主キーの一意性
- 複数CSV間の参照整合性
- delimiter、encoding、header行数などのdialect
- CSVからJSON、RDF、DBへ変換するときの意味
CSVWはDBそのものではありません。メタデータは交換時の契約であり、保存先ではPRIMARY KEY、FOREIGN KEY、NOT NULL、CHECKなどへ対応付けます。
最小のCSVとメタデータ
部品表の元になるparts.csvを考えます。
part_id,name,mass_kg,material_id,released_on,active
P-001,Bracket,1.250,MAT-01,2026-10-01,true
P-002,Shaft,12.500,MAT-02,2026-10-03,false対応するparts.csv-metadata.jsonは次のように書けます。
{
  "@context": "http://www.w3.org/ns/csvw",
  "url": "parts.csv",
  "tableSchema": {
    "columns": [
      {
        "name": "part_id",
        "titles": "part_id",
        "datatype": "string",
        "required": true
      },
      {
        "name": "name",
        "titles": "name",
        "datatype": "string",
        "required": true
      },
      {
        "name": "mass_kg",
        "titles": "mass_kg",
        "datatype": "decimal",
        "required": true
      },
      {
        "name": "material_id",
        "titles": "material_id",
        "datatype": "string",
        "required": true
      },
      {
        "name": "released_on",
        "titles": "released_on",
        "datatype": "date",
        "null": "",
        "required": false
      },
      {
        "name": "active",
        "titles": "active",
        "datatype": "boolean",
        "required": true
      }
    ],
    "primaryKey": "part_id"
  }
}columnsはcolumn定義のarrayです。各objectのnameがプログラム内部で使うfield名、titlesがCSV headerとの対応、datatypeがcellを解釈する型です。primaryKeyは一つのcolumn名だけでなく、複合キーならcolumn名のarrayにもできます。
入力から出力までの処理順
CSVWを使う処理は、単にCSVを開いて型変換するだけではありません。安全な取込では、次の順序を固定します。
- CSVとメタデータをbyte列として取得する
- 指定したencodingとdialectでCSVを解析する
- headerと
columnsの対応を確認する null表現を判定してからdatatypeへ変換するrequired、範囲、形式などを検証するprimaryKeyの重複を確認する- 全tableを読んだ後に
foreignKeysを確認する - 正常recordとエラーrecordを分離する
- staging tableへ保存し、全体が有効なら本番へ反映する
header確認を後回しにすると、列の追加や順序変更を誤って別fieldへ読み込む危険があります。行番号だけでなく、table名、column名、エラーcode、元の値を記録すると、修正と再取込が容易になります。
{
  "table": "parts.csv",
  "row": 3,
  "column": "material_id",
  "code": "foreign_key_not_found",
  "value": "MAT-99"
}
NULL・空文字・必須条件を分ける
CSVWのnullは、どの文字列をNULLとして扱うかを指定します。仕様上、未指定時の既定値は空文字です。required: trueは、変換後のcell valueがNULLになることを許さない指定です。
この二つは別の役割を持ちます。
null: "":空cellをNULLへ変換するrequired: true:NULLになったcellをエラーにするrequired: false:NULLを受理する
空文字そのものを有効なstringとして保存したいなら、空cellを既定のNULL表現に任せてはいけません。たとえばnull: "NULL"のように専用表現を決め、利用者が入力する文字列NULLと衝突しないことを確認します。
0、false、""はNULLではありません。Pythonでもif not value:でまとめて欠損扱いせず、NULL表現との一致を先に判定します。
数値・日時・真偽値・IDの落とし穴
IDは数値に見えてもstringにする
0012、00004567のようなIDは計算対象ではありません。integerへ変換すると先頭ゼロが消えるため、datatype: "string"とします。主キーの役割とdatatypeは別問題です。
decimalはfloatへ直行させない
金額、質量、寸法など桁管理が必要な値は、PythonではDecimalへ変換します。binary浮動小数点数へ変換すると、十進小数を正確に保持できない場合があります。保存先DBの精度とscaleも、CSVWとは別に契約へ含めます。
dateとdatetimeを混同しない
2026-10-01はdateであり、時刻やtimezoneを持ちません。瞬間を表す値にはUTC offsetを含むdatetimeを使い、ローカル時刻だけを送らないようにします。CSVWのdatatypeだけで業務上の締切時刻やtimezone規則まで決まるわけではありません。
booleanの受理表現を固定する
true、false、1、0、yes、noを無条件に同じものとして扱うと、送信元ごとに意味が変わります。受理する表現を限定し、出力時は一つの表現へ正規化します。
複数CSVの参照関係を表す
材料マスターmaterials.csvを追加します。
material_id,name
MAT-01,Aluminum alloy
MAT-02,Carbon steel
複数tableを一つのtable groupとして記述すると、parts.csvのmaterial_idから材料マスターへの参照をforeignKeysで表せます。
{
  "@context": "http://www.w3.org/ns/csvw",
  "tables": [
    {
      "url": "materials.csv",
      "tableSchema": {
        "columns": [
          {"name": "material_id", "datatype": "string", "required": true},
          {"name": "name", "datatype": "string", "required": true}
        ],
        "primaryKey": "material_id"
      }
    },
    {
      "url": "parts.csv",
      "tableSchema": {
        "columns": [
          {"name": "part_id", "datatype": "string", "required": true},
          {"name": "name", "datatype": "string", "required": true},
          {"name": "mass_kg", "datatype": "decimal", "required": true},
          {"name": "material_id", "datatype": "string", "required": true},
          {"name": "released_on", "datatype": "date", "null": ""},
          {"name": "active", "datatype": "boolean", "required": true}
        ],
        "primaryKey": "part_id",
        "foreignKeys": [
          {
            "columnReference": "material_id",
            "reference": {
              "resource": "materials.csv",
              "columnReference": "material_id"
            }
          }
        ]
      }
    }
  ]
}検証器は、参照元の値が参照先tableの指定columnに存在し、対応する行が一意であることを確認します。参照先にprimaryKeyを定義するのが自然ですが、CSVW仕様上、外部キーの参照先へ同じ主キー定義が必須というわけではありません。実務では参照先の一意性を別の制約でも保証します。
Pythonで最小の検証器を作る
次の例はPython標準libraryだけで、CSVWの一部を利用する最小実装です。完全なCSVW processorではなく、string、integer、decimal、date、boolean、単一columnの主キーと外部キーに範囲を限定しています。
import csv
import json
from datetime import date
from decimal import Decimal, InvalidOperation
from pathlib import Path


def convert(raw, column):
    null_values = column.get("null", "")
    if isinstance(null_values, str):
        null_values = [null_values]
    if raw in null_values:
        if column.get("required", False):
            raise ValueError("required value is null")
        return None

    datatype = column.get("datatype", "string")
    if isinstance(datatype, dict):
        datatype = datatype["base"]

    if datatype == "string":
        return raw
    if datatype == "integer":
        return int(raw)
    if datatype == "decimal":
        try:
            return Decimal(raw)
        except InvalidOperation as exc:
            raise ValueError("invalid decimal") from exc
    if datatype == "date":
        return date.fromisoformat(raw)
    if datatype == "boolean":
        values = {"true": True, "false": False}
        if raw not in values:
            raise ValueError("boolean must be true or false")
        return values[raw]
    raise ValueError(f"unsupported datatype: {datatype}")


def load_table(base_dir, table):
    schema = table["tableSchema"]
    columns = schema["columns"]
    names = [column["name"] for column in columns]
    rows = []
    errors = []

    with (base_dir / table["url"]).open(
        "r", encoding="utf-8", newline=""
    ) as file:
        reader = csv.DictReader(file)
        if reader.fieldnames != names:
            raise ValueError(
                f"header mismatch: expected {names}, got {reader.fieldnames}"
            )
        for row_number, source in enumerate(reader, start=2):
            record = {}
            for column in columns:
                name = column["name"]
                try:
                    record[name] = convert(source[name], column)
                except (ValueError, TypeError) as exc:
                    errors.append({
                        "table": table["url"],
                        "row": row_number,
                        "column": name,
                        "code": "invalid_value",
                        "value": source[name],
                        "message": str(exc),
                    })
            rows.append(record)

    primary_key = schema.get("primaryKey")
    if isinstance(primary_key, str):
        seen = set()
        for row_number, record in enumerate(rows, start=2):
            value = record.get(primary_key)
            if value in seen:
                errors.append({
                    "table": table["url"],
                    "row": row_number,
                    "column": primary_key,
                    "code": "duplicate_primary_key",
                    "value": str(value),
                })
            seen.add(value)

    return rows, errors


base_dir = Path(".")
metadata = json.loads(
    (base_dir / "table-group-metadata.json").read_text(encoding="utf-8")
)

loaded = {}
all_errors = []
for table in metadata["tables"]:
    rows, errors = load_table(base_dir, table)
    loaded[table["url"]] = rows
    all_errors.extend(errors)

for table in metadata["tables"]:
    schema = table["tableSchema"]
    for foreign_key in schema.get("foreignKeys", []):
        source_column = foreign_key["columnReference"]
        reference = foreign_key["reference"]
        target_rows = loaded[reference["resource"]]
        target_column = reference["columnReference"]
        target_values = {row.get(target_column) for row in target_rows}

        for row_number, record in enumerate(loaded[table["url"]], start=2):
            value = record.get(source_column)
            if value is not None and value not in target_values:
                all_errors.append({
                    "table": table["url"],
                    "row": row_number,
                    "column": source_column,
                    "code": "foreign_key_not_found",
                    "value": str(value),
                })

if all_errors:
    print(json.dumps(all_errors, ensure_ascii=False, indent=2))
else:
    print("validation passed")
本番では、W3C仕様に準拠した既存processorの利用も検討します。独自実装をする場合は、対応するdatatype、format、dialect、複合キー、相対URL解決、警告とエラーの扱いを明記し、「CSVW対応」と広く表現しすぎないことが重要です。
正常系と異常系をテストする
正常系だけでなく、少なくとも次の入力を自動テストします。
- header名、順序、列数が契約どおり
- 必須cellがNULLではない
0012がstringのまま保持される- decimalとdateが正しく変換される
- booleanの未知表現を拒否する
- 主キーの重複を拒否する
- 外部キーの参照先なしを拒否する
- 引用符内のcommaと改行を正しく読める
- UTF-8以外のbyte列を意図せず受理しない
- 余分なcolumnを拒否するか許可するかが一定
エラーが一件あったときに全取込を中止するのか、有効行だけ受理するのかも契約です。部品表や設計属性では中途半端な反映が参照切れを生むため、全件検証後にtransactionでまとめて反映する方式が扱いやすくなります。
冪等性と再実行を設計する
CSVWが保証するのはデータの解釈と検証であり、再実行時の重複排除ではありません。取込処理には別の識別情報が必要です。
- fileのSHA-256とmetadata versionを取込単位として保存する
- 業務recordは安定した主キーでUPSERTする
- 同じ取込IDの成功結果を再利用する
- staging tableで検証してから本番へ反映する
- source versionが古い場合は上書きを拒否する
- 削除を表す方法を全件置換、tombstone、差分操作のいずれかに固定する
「行を追加する」だけの処理は、同じfileの再送で重複します。最終状態を主キーで指定する処理なら、同じ入力を再実行しても業務上の結果を同じにできます。
セキュリティと秘密情報の分離
CSVとmetadataは外部入力です。検証器が信頼できるとは限りません。
- metadataが参照できるresourceのschemeと保存先をallowlist化する
- 相対pathを正規化し、許可directory外を読ませない
- file size、row数、column数、cell長へ上限を設ける
- formula injectionを避けるため、表計算へ再出力する値を別途検査する
- エラーログへ個人情報や機密値をそのまま残さない
- API keyやtokenをCSVとmetadataへ含めず、秘密情報管理へ分離する
- 外部URLの自動取得ではSSRF対策とtimeoutを設ける
datatype: "string"は安全宣言ではありません。SQL、HTML、shell、表計算へ出力するときは、それぞれの出力先に応じたparameter bindingやescapeが必要です。
DB・API・CADへ再利用する
CSVWメタデータを変換契約の中心に置くと、一つの定義を複数の入口で利用できます。
nameをDB column名やAPI field名へ対応付けるdatatypeをPython変換とDB型へ対応付けるrequiredを入力検証とNOT NULLへ対応付けるprimaryKeyを重複排除とDB主キーへ対応付けるforeignKeysをBOM、材料、図面、部品の参照確認へ使う- metadata versionをmigrationと監査記録へ残す
CADから出力した部品属性CSVにも、部品ID、revision、材質ID、単位付き寸法などの意味を付けられます。ただし、CSVWのdatatypeだけでは「寸法の単位はmm」「質量はkg」といった業務意味を十分に表せません。単位column、説明、別のデータ辞書を併用し、値と単位を分離します。
まとめ
CSVWは、CSVの外側に機械可読なスキーマを置き、読み手ごとの推測を減らす仕組みです。
- CSVとJSON metadataを別々の役割として管理する
columnsでfield名、header、datatypeを定義するnullとrequiredを分けて考える- IDは見た目が数字でもstringとして扱う
- decimal、date、booleanの受理表現を固定する
primaryKeyで重複、foreignKeysで参照切れを検出する- 型変換後に主キーと外部キーを検証する
- staging、取込ID、hashで安全に再実行する
- 秘密情報と外部resource取得を分離する
- DB、API、CADでも同じfield契約を再利用する
CSVを「開けるfile」から「検証して再利用できるdata contract」へ変えるには、値だけでなく、その意味と関係を一緒に渡す設計が必要です。