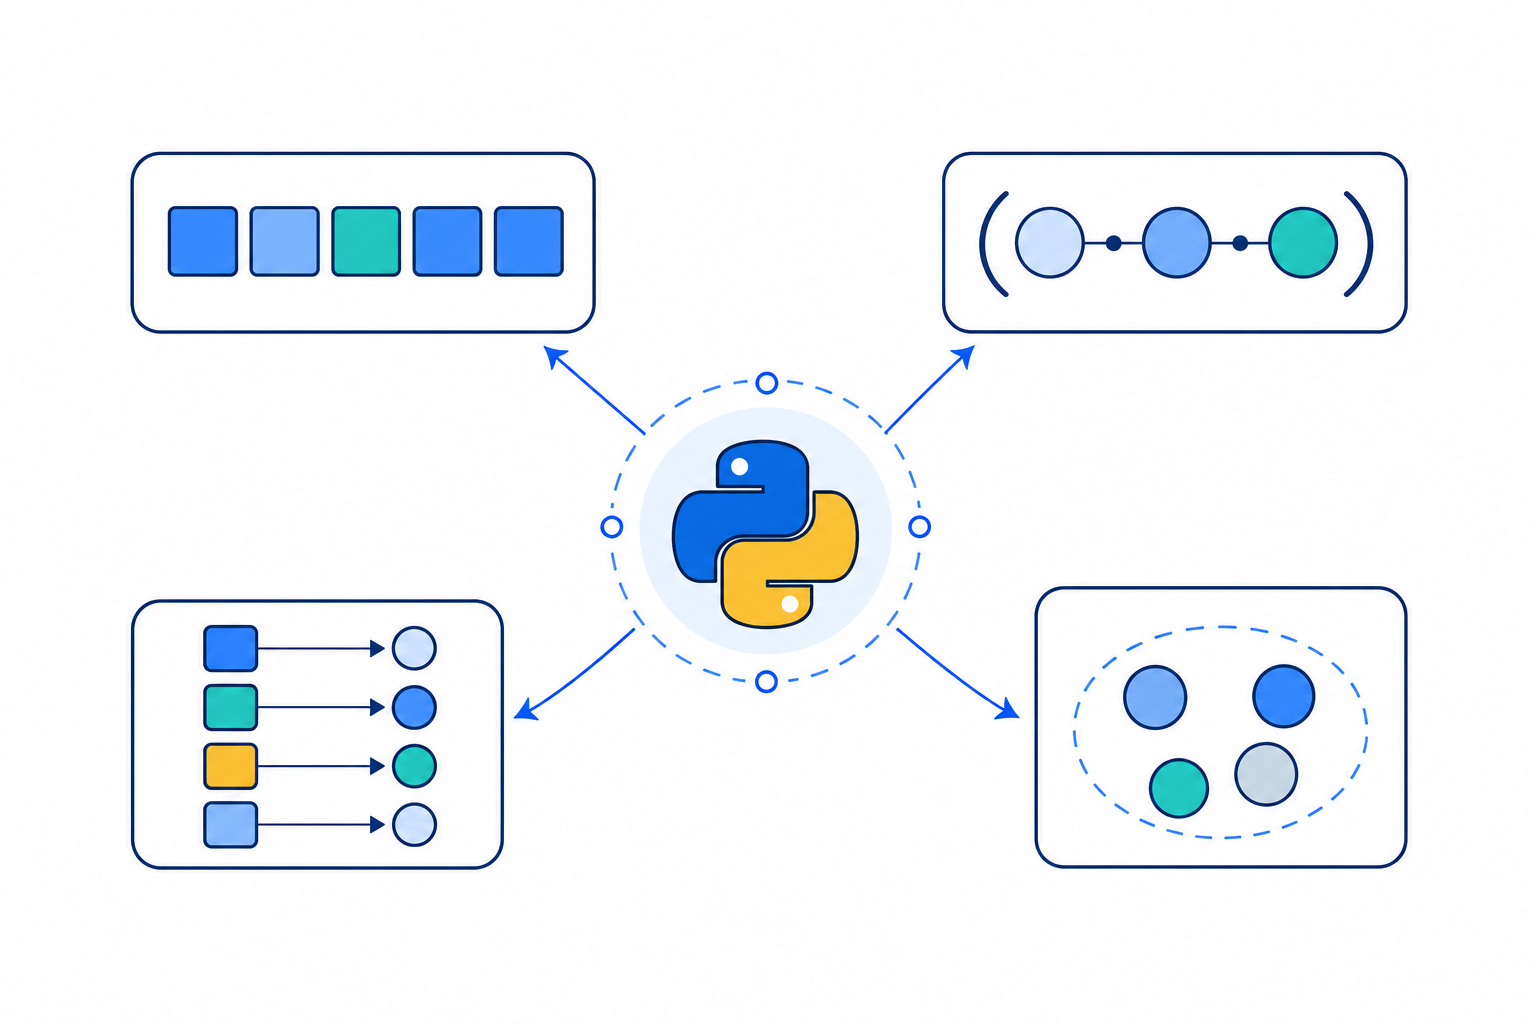
複数の圧力値、シリンダの寸法、部品の属性、重複を除いた材料記号。こうしたデータをPythonで扱うには、値をまとめるためのデータ構造が必要です。
Pythonには、標準で次の代表的なコレクションがあります。
list:順番のある、変更可能なデータtuple:順番のある、変更しないデータdict:キーと値を対応させたデータset:重複のないデータ
どれも複数の値を保持できますが、役割は同じではありません。この記事では、4種類の違いを工学データの例で整理します。
今日の到達点
この記事を読み終えると、次のことができるようになります。
list、tuple、dict、setの違いを説明できる- 順序、重複、可変性を基準に構造を選べる
- 要素の追加、更新、削除、参照ができる
- 複数の値を順番に処理できる
- 辞書で値の意味と単位を表現できる
- リストと辞書を組み合わせて複数レコードを表現できる
4種類の違い
最初に全体像を比較します。
| 型 | 記述例 | 順序 | 重複 | 作成後の変更 | 主な参照方法 |
|---|---|---|---|---|---|
list | [7.0, 14.0] | あり | 可 | 可 | インデックス |
tuple | (80.0, 45.0) | あり | 可 | 不可 | インデックス |
dict | {"bore_mm": 80.0} | 挿入順 | キーは不可 | 可 | キー |
set | {"S45C", "SS400"} | なし | 不可 | 可 | 所属確認 |
「複数の値だから、とりあえずリスト」ではなく、データの意味に合う構造を選ぶことが重要です。
list:順番のある変更可能なデータ
リストは角括弧[]で作成します。
pressures_mpa = [7.0, 14.0, 21.0]

print(pressures_mpa)
print(type(pressures_mpa))
実行結果です。
[7.0, 14.0, 21.0]
<class 'list'>
リストは順序を保持し、同じ値を複数回格納できます。
pressures_mpa = [7.0, 14.0, 14.0]

print(pressures_mpa)
実行結果です。
[7.0, 14.0, 14.0]Python公式ドキュメントでは、リストは変更可能なシーケンスで、一般に同種の項目を集めるために使われると説明されています。Pythonのリスト型を参照してください。
要素を参照する
リストの位置は0から始まります。
pressures_mpa = [7.0, 14.0, 21.0]

print(pressures_mpa[0])
print(pressures_mpa[1])
print(pressures_mpa[-1])
実行結果です。
7.0
14.0
21.0
文字列と同様に、スライスも使えます。
print(pressures_mpa[0:2])実行結果です。
[7.0, 14.0]追加する
末尾への追加にはappend()を使います。
pressures_mpa = [7.0, 14.0]
pressures_mpa.append(21.0)

print(pressures_mpa)
実行結果です。
[7.0, 14.0, 21.0]複数の値を追加する場合はextend()を使えます。
pressures_mpa.extend([10.5, 17.5])

print(pressures_mpa)
実行結果です。
[7.0, 14.0, 21.0, 10.5, 17.5]append([10.5, 17.5])とすると、リストの中に別のリストが1要素として追加されます。append()とextend()では結果の構造が異なります。
更新する
インデックスを指定して値を更新できます。
pressures_mpa = [7.0, 14.0, 21.0]
pressures_mpa[1] = 13.5

print(pressures_mpa)
実行結果です。
[7.0, 13.5, 21.0]削除する
値を指定するならremove()を使います。
pressures_mpa = [7.0, 14.0, 21.0]
pressures_mpa.remove(14.0)

print(pressures_mpa)
実行結果です。
[7.0, 21.0]位置を指定して削除し、その値も受け取りたい場合はpop()を使います。
pressures_mpa = [7.0, 14.0, 21.0]
removed_pressure = pressures_mpa.pop(1)

print(removed_pressure)
print(pressures_mpa)
実行結果です。
14.0
[7.0, 21.0]存在しない値をremove()で削除するとValueError、存在しない位置をpop()で指定するとIndexErrorになります。
tuple:順番のある変更しないデータ
タプルは、一般に丸括弧()を使って記述します。
cylinder_size_mm = (80.0, 45.0, 500.0)

print(cylinder_size_mm)
print(type(cylinder_size_mm))
実行結果です。
(80.0, 45.0, 500.0)
<class 'tuple'>
この例では、値を次の順序と決めています。
- 要素0:シリンダ内径 mm
- 要素1:ロッド径 mm
- 要素2:ストローク mm
タプルもインデックスで参照できます。
print(cylinder_size_mm[0])実行結果です。
80.0ただし、作成後に要素を置き換えることはできません。
cylinder_size_mm[0] = 100.0このコードは次のTypeErrorになります。
TypeError: 'tuple' object does not support item assignmentPython公式チュートリアルでも、タプルはイミュータブル、つまり要素を直接変更できない構造として説明されています。タプルとシーケンスを参照してください。
タプルを分解して受け取る
各要素を複数の変数へ一度に代入できます。これをアンパックと呼びます。
cylinder_size_mm = (80.0, 45.0, 500.0)
bore_mm, rod_mm, stroke_mm = cylinder_size_mm

print(bore_mm)
print(rod_mm)
print(stroke_mm)
実行結果です。
80.0
45.0
500.0左側の変数数とタプルの要素数が一致しない場合はValueErrorになります。
1要素のタプル
1要素のタプルでは、値の後ろにカンマが必要です。
not_tuple = (80.0)
one_item_tuple = (80.0,)

print(type(not_tuple))
print(type(one_item_tuple))
実行結果です。
<class 'float'>
<class 'tuple'>
タプルを作る本質的な記号は丸括弧ではなくカンマです。丸括弧だけでは、通常の式を囲んだものとして解釈されます。
listとtupleの使い分け
リストは、後から追加や削除を行うデータに適しています。
measurement_values_mpa = [13.8, 14.1, 13.9]タプルは、要素数や並びを固定して扱いたいデータに適しています。
point_xyz_mm = (120.0, 45.0, 30.0)ただし、タプルにしただけで各位置の意味が明確になるわけではありません。
cylinder_size_mm = (80.0, 45.0, 500.0)この値だけを見ても、どの位置が内径、ロッド径、ストロークなのか分かりにくい場合があります。意味の異なる属性を名前で参照したい場合は辞書が適しています。
dict:キーと値を対応させる
辞書は、キーと値をkey: valueの形で対応させます。
component = {
    "name": "Cylinder A",
    "bore_mm": 80.0,
    "pressure_mpa": 14.0,
}

print(component)
実行結果です。
{'name': 'Cylinder A', 'bore_mm': 80.0, 'pressure_mpa': 14.0}この辞書では、次の対応関係を表しています。
name→ 部品名bore_mm→ 内径 mmpressure_mpa→ 圧力 MPa
値の位置を覚える必要がなく、意味を示すキーで参照できます。
print(component["name"])
print(component["bore_mm"])
実行結果です。
Cylinder A
80.0
追加と更新
新しいキーを指定すると項目が追加されます。
component["stroke_mm"] = 500.0既存のキーを指定すると値が更新されます。
component["pressure_mpa"] = 16.0結果を確認します。
print(component)実行結果です。
{'name': 'Cylinder A', 'bore_mm': 80.0, 'pressure_mpa': 16.0, 'stroke_mm': 500.0}辞書のキーは同じ辞書内で一意です。同じキーへ再代入しても、項目が重複して増えるのではなく、対応する値が更新されます。
削除する
del component["stroke_mm"]

print(component)
実行結果です。
{'name': 'Cylinder A', 'bore_mm': 80.0, 'pressure_mpa': 16.0}存在しないキーをdelで削除するとKeyErrorになります。
存在しないキーへ安全にアクセスする
角括弧で存在しないキーを参照するとKeyErrorになります。
print(component["material"])必須ではない項目なら、get()で初期値を指定できます。
material = component.get("material", "未設定")

print(material)
実行結果です。
未設定必須項目の入力漏れまで初期値で隠してしまうと、不完全なデータの見落としにつながります。get()を使うかエラーにするかは、その項目が必須か任意かで判断します。
辞書にも順序がある
現在のPythonでは、辞書はキーが追加された順序を保持します。既存キーの値を更新しても位置は変わらず、削除後に同じキーを追加し直すと末尾へ入ります。Pythonの辞書型では、挿入順序の保証が明記されています。
ただし、辞書の主目的は位置番号ではなく、キーから値を取得することです。component["bore_mm"]のように意味のあるキーで参照します。
set:重複のない要素を扱う
集合は、重複しない要素を保持します。
materials = {"S45C", "SS400", "S45C"}

print(len(materials))
実行結果です。
2"S45C"を2回記述しても、集合内では1要素です。
集合は順序を記録しません。表示や反復の順番を前提にせず、必要ならsorted()で並べ替えます。
print(sorted(materials))実行結果です。
['S45C', 'SS400']公式ドキュメントでは、集合は重複しないハッシュ可能なオブジェクトからなる、順序を持たないコレクションと定義されています。Pythonの集合型を参照してください。
追加と削除
materials = {"S45C", "SS400"}
materials.add("SUS304")
materials.remove("SS400")

print(sorted(materials))
実行結果です。
['S45C', 'SUS304']remove()は対象が存在しないとKeyErrorになります。存在しなくてもエラーにしたくない場合はdiscard()を使います。
materials.discard("A5052")空の集合
空の集合はset()で作ります。
materials = set(){}は空の集合ではなく、空の辞書です。
print(type(set()))
print(type({}))
実行結果です。
<class 'set'>
<class 'dict'>
集合演算
検査に必要なタグと、入力データに付いているタグを比較します。
required_tags = {"hydraulic", "checked", "metric"}
input_tags = {"metric", "hydraulic", "prototype"}

matched_tags = required_tags & input_tags
missing_tags = required_tags - input_tags

print(sorted(matched_tags))
print(sorted(missing_tags))
実行結果です。
['hydraulic', 'metric']
['checked']
主な集合演算は次のとおりです。
| 演算 | 意味 |
|---|---|
a & b | 両方に含まれる要素 |
a | b | どちらかに含まれる要素 |
a - b | aにだけ含まれる要素 |
a ^ b | 片方だけに含まれる要素 |
集合は、重複除去、対応機能の比較、必須項目の不足確認などに向いています。
反復して要素を取り出す
複数の要素を順番に取り出すにはforを使います。
pressures_mpa = [7.0, 14.0, 21.0]

for pressure_mpa in pressures_mpa:
    print(f"{pressure_mpa:.1f} MPa")
実行結果です。
7.0 MPa
14.0 MPa
21.0 MPa辞書では、items()を使うとキーと値を同時に取り出せます。
component = {
    "name": "Cylinder A",
    "bore_mm": 80.0,
    "pressure_mpa": 14.0,
}

for key, value in component.items():
    print(key, value)
実行結果です。
name Cylinder A
bore_mm 80.0
pressure_mpa 14.0forによる反復処理はDay 6で詳しく扱います。ここでは「コレクションから要素を1つずつ取り出せる」と理解できれば十分です。
工学データを表現する
複数の機器を表す場合は、「1機器を辞書」「機器の集まりをリスト」とする方法があります。
components = [
    {
        "name": "Cylinder A",
        "pressure_mpa": 14.0,
        "area_mm2": 5026.548,
    },
    {
        "name": "Cylinder B",
        "pressure_mpa": 7.0,
        "area_mm2": 1963.495,
    },
]

for component in components:
    force_kn = (
        component["pressure_mpa"]
        * component["area_mm2"]
        / 1000
    )

    print(f'{component["name"]}: {force_kn:.2f} kN')
実行結果です。
Cylinder A: 70.37 kN
Cylinder B: 13.74 kN
この構造には次の利点があります。
- リストによって複数機器を順番に保持できる
- 辞書のキーで各値の意味が分かる
pressure_mpaやarea_mm2に単位を明示できる- CSVやJSONへ展開しやすい
- 機器を追加するときは辞書を1件追加できる
一方、すべての辞書に同じキーが存在するとは限りません。計算前に必須キー、値の型、単位、許容範囲を確認する設計が必要です。
可変と不変
作成後に内容を変更できる性質をミュータブル、変更できない性質をイミュータブルと呼びます。
| 型 | 可変性 |
|---|---|
list | ミュータブル |
tuple | イミュータブル |
dict | ミュータブル |
set | ミュータブル |
可変なオブジェクトでは、複数の変数が同じデータを参照している場合に注意が必要です。
original = [7.0, 14.0]
copied = original

copied.append(21.0)

print(original)
実行結果です。
[7.0, 14.0, 21.0]copied = originalはリストの複製ではありません。両方の変数が同じリストを参照します。
別のリストとして複製したい場合は、copy()を使えます。
original = [7.0, 14.0]
copied = original.copy()

copied.append(21.0)

print(original)
print(copied)
実行結果です。
[7.0, 14.0]
[7.0, 14.0, 21.0]ただし、copy()は浅いコピーです。リストの中に別のリストや辞書がある場合、その内側のオブジェクトまですべて独立するとは限りません。
選び方の基準
迷ったときは、次の順で考えます。
順番と変更が必要か
測定履歴や処理待ちデータのように、順番を保ちながら追加・削除するならリストが候補です。
作成後に変えない並びか
座標や固定された組み合わせなど、順番に意味があり、要素を変更しないならタプルが候補です。
各値へ名前を付けたいか
内径、圧力、材料のように、値ごとの意味をキーで表したいなら辞書が適しています。
重複を除きたいか
材料記号、タグ、処理済みIDのように、同じ値を1回だけ保持したいなら集合が適しています。
データ構造は短く書くためだけのものではありません。「このデータは順番を持つのか」「変更してよいのか」「重複してよいのか」という設計上の前提をコードに表すものです。
よくある失敗
setを順番付きデータとして使う
集合は要素の位置や挿入順序を記録しません。data[0]のようなインデックス参照もできません。
順番が必要ならリストやタプルを選びます。
辞書で存在しないキーを参照する
component = {"name": "Cylinder A"}
print(component["pressure_mpa"])このコードはKeyErrorになります。必須キーなら入力データの不足として処理し、任意キーならget()を検討します。
listとtupleを見た目だけで選ぶ
リストとタプルはどちらも順序を持ちます。違いの中心は、作成後の変更を許すかどうかです。
単位を値から推測する
component = {"pressure": 14.0}この値がPa、MPa、barのどれか分かりません。
component = {"pressure_mpa": 14.0}単位をキーへ含めると、計算時の取り違えを減らせます。
練習問題
測定値を更新する
次のリストへ13.8を追加し、先頭の13.5を13.6へ更新してください。
pressures_mpa = [13.5, 14.0]解答例です。
pressures_mpa = [13.5, 14.0]

pressures_mpa.append(13.8)
pressures_mpa[0] = 13.6

print(pressures_mpa)
実行結果です。
[13.6, 14.0, 13.8]辞書で部品を表現する
部品名、内径、ストロークを、単位が分かるキーで表現してください。
解答例です。
component = {
    "name": "Cylinder A",
    "bore_mm": 80.0,
    "stroke_mm": 500.0,
}

print(component["bore_mm"])
実行結果です。
80.0不足タグを求める
必須タグと入力タグの差集合から、不足しているタグを求めてください。
required_tags = {"metric", "checked", "approved"}
input_tags = {"metric", "checked"}
解答例です。
missing_tags = required_tags - input_tags

print(sorted(missing_tags))
実行結果です。
['approved']まとめ
Pythonの4種類のコレクションは、それぞれ異なる前提を表します。
- リストは順序を持ち、追加・更新・削除できる
- タプルは順序を持つが、要素を変更できない
- 辞書は一意なキーと値を対応させる
- 辞書はキーの挿入順序を保持する
- 集合は順序を持たず、重複を除去する
- 空の集合は
set()で作り、{}は空の辞書になる forを使うと要素を順番に取り出せる- リストと辞書を組み合わせると複数レコードを表現できる
- 工学データではキーや変数名へ単位を明示する
- 可変なデータを複数の変数から参照するときは変更の影響に注意する
データ構造を適切に選ぶと、値を保存できるだけでなく、データの意味や変更ルールもコードから読み取れるようになります。