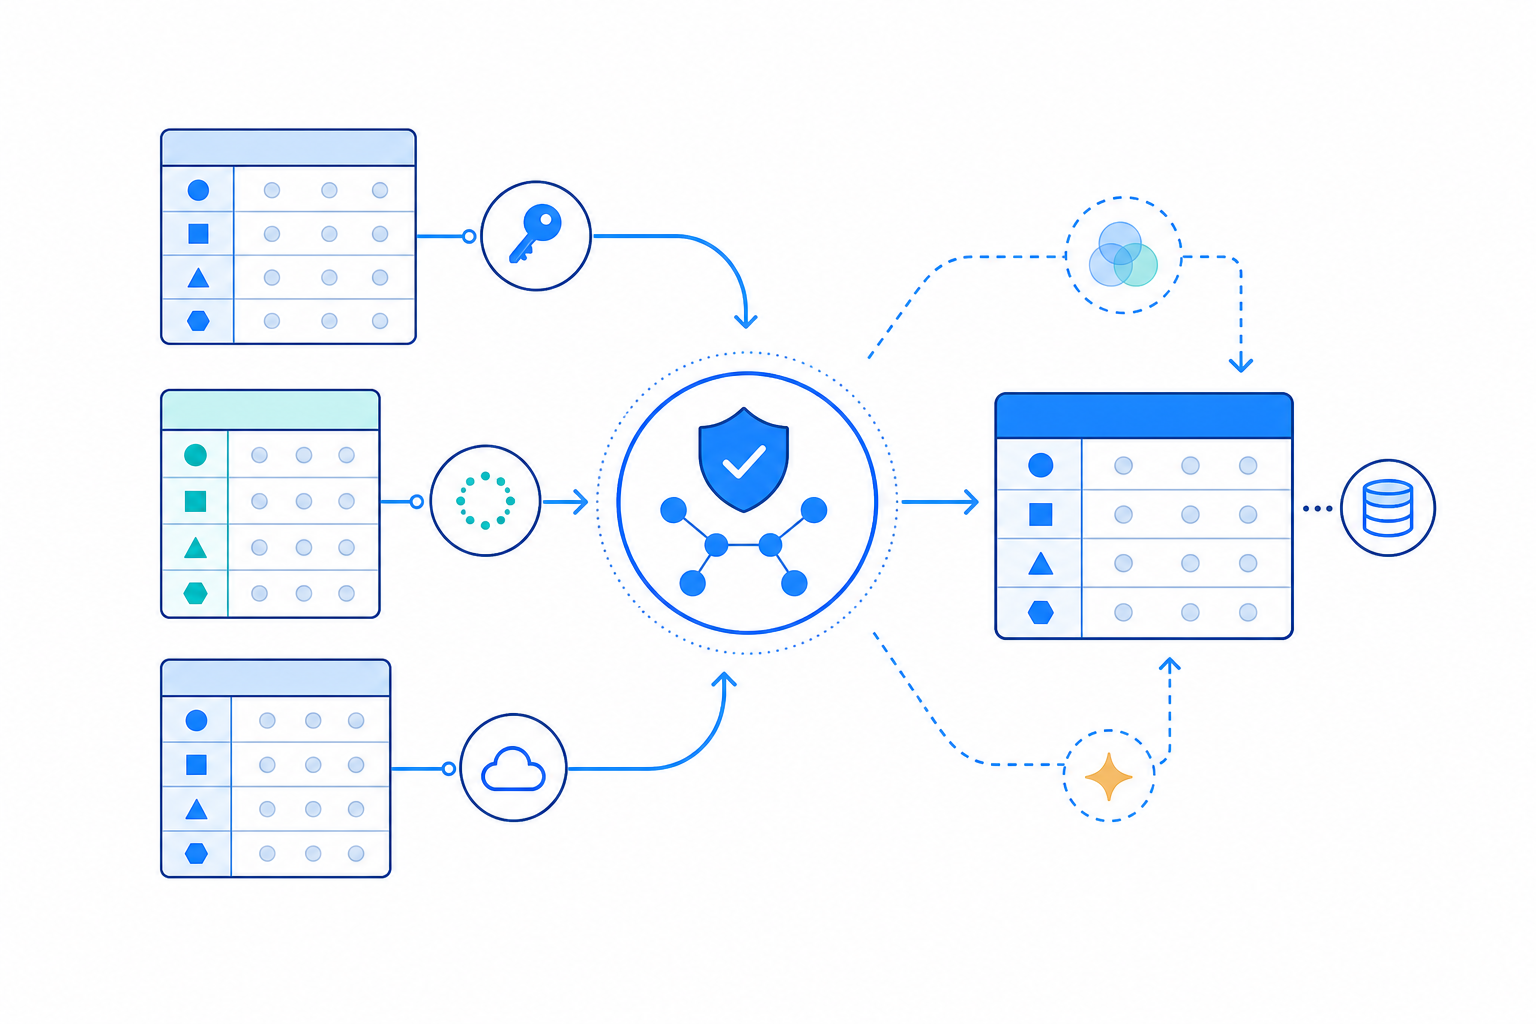
データ連携では、値を正しく変換できても「同じものを同じものとして認識できない」と処理が破綻します。
同じ部品の二重登録、名称変更による別レコード化、異なるシステム間での123の衝突。こうした問題の中心にあるのがID設計です。
この記事では、自然キー、サロゲートキー、外部ID、UUIDの役割を分け、API、CSV、SQLite、Pythonへ再利用できる形で整理します。
IDが解決する問題
IDは、データの同一性を判断し、別のレコードから参照するための契約です。
IDには、少なくとも次の性質が求められます。
- 対象範囲内で一意である
- 一度割り当てた後は原則として変わらない
- 名称や説明など、変更される属性から独立している
- 再送時に既存レコードを特定できる
社内DBだけで一意ならよいのか、複数拠点や外部サービスまで含めるのかを先に決めます。
IDを役割で分ける
一つのIDにすべての役割を持たせず、内部ID、業務キー、外部IDを分けます。
内部ID
自システムがレコードを識別するためのIDです。DBの主キーやAPIリソースIDに使います。
c7c62688-8d7d-43fe-8f8e-4f2b913f8ed2内部IDには業務上の意味を埋め込まず、名称や分類が変わっても同じ値を維持します。このような人工的な識別子はサロゲートキーと呼ばれます。
自然キー・業務キー
業務データの中にもともと存在し、対象を一意にできる値です。部品番号、図面番号、社員番号などが候補になります。
CYL-040-200人が検索しやすい一方、採番規則の変更や改番があり得ます。DBの主キーにすると参照先まで影響するため、内部IDとは分ける設計が安全です。
外部ID
連携元システムが持つ識別子です。外部IDだけでは範囲が分からないため、通常は連携元を示す値と組み合わせます。
{
  "source_system": "cad-master",
  "source_record_id": "A-004812"
}別システムにもA-004812が存在し得るため、source_systemとsource_record_idの組み合わせを一意にします。
最小のデータ構造
設計部品を連携する例では、次のように役割を分離できます。
{
  "id": "c7c62688-8d7d-43fe-8f8e-4f2b913f8ed2",
  "asset_code": "CYL-040-200",
  "source": {
    "system": "cad-master",
    "record_id": "A-004812"
  },
  "name": "Hydraulic cylinder"
}id:自システム内で不変の主識別子asset_code:人が扱う業務コードsource.system:連携元の名前空間source.record_id:連携元でのレコードIDname:変更可能な属性
名称や部品番号が変わっても、同一部品ならidは変えません。
入力から保存までの流れ
IDを使った連携処理は、次の順序に分けられます。
外部データ受信
  ↓
型・必須項目を検証
  ↓
ID表記を正規化
  ↓
source_system + source_record_idで既存検索
  ↓
存在しない → 内部IDを発行してINSERT
存在する   → 同じ内部IDのレコードをUPDATE
  ↓
内部IDを結果として返す
内部IDの発行前に外部IDを照合すれば、同じデータが再送されても同じレコードへ収束します。
SQLiteで一意性を制約にする
重複防止をアプリケーションのif文だけに任せず、DB側にも制約を置きます。
CREATE TABLE assets (
    id               TEXT PRIMARY KEY NOT NULL,
    asset_code       TEXT NOT NULL UNIQUE,
    source_system    TEXT NOT NULL,
    source_record_id TEXT NOT NULL,
    name             TEXT NOT NULL,
    created_at       TEXT NOT NULL,
    updated_at       TEXT NOT NULL,
    UNIQUE (source_system, source_record_id)
);
このテーブルでは、DBが次を保証します。
idは内部主キーとして重複不可asset_codeは業務上重複不可- 外部IDは連携元との組み合わせで重複不可
- 必須IDへ
NULLを保存できない
SQLiteには主キー列でのNULLに歴史的な例外があるため、文字列主キーにはNOT NULLも明示します。SQLite公式仕様でも各制約は別々に説明されています。
履歴として同じasset_codeを複数保持する場合は、履歴モデルに合う制約を設計します。
UUIDv4とUUIDv7の使い分け
RFC 9562はUUIDを128bitの識別子として定義しています。中央管理なしで生成でき、分散システムに向きます。
代表的な選択肢はUUIDv4とUUIDv7です。
UUIDv4
ランダムまたは疑似ランダムな値を基に生成します。広く利用されていますが、生成順には並びません。
UUIDv7
先頭側にUnix Epochのミリ秒時刻を持ち、DBインデックス上で近く並びやすいUUIDです。
ただし、UUIDv7には生成時刻に由来する情報が含まれます。IDからおおよその生成順や時刻を知られたくない用途では、公開範囲を含めて検討が必要です。
一般的なAPIではUUIDv4から始められます。大量挿入時のインデックス局所性が重要ならUUIDv7を候補にし、フィールドごとに方式を固定します。
Pythonで再実行可能な登録処理を作る
次の例では、外部IDの組み合わせが初回なら追加し、再送なら同じレコードを更新します。
import sqlite3
import uuid


def upsert_asset(conn: sqlite3.Connection, data: dict) -> str:
    new_id = str(uuid.uuid4())

    conn.execute(
        """
        INSERT INTO assets (
            id, asset_code, source_system, source_record_id,
            name, created_at, updated_at
        )
        VALUES (?, ?, ?, ?, ?, CURRENT_TIMESTAMP, CURRENT_TIMESTAMP)
        ON CONFLICT (source_system, source_record_id)
        DO UPDATE SET
            asset_code = excluded.asset_code,
            name = excluded.name,
            updated_at = CURRENT_TIMESTAMP
        """,
        (
            new_id,
            data["asset_code"],
            data["source_system"],
            data["source_record_id"],
            data["name"],
        ),
    )

    row = conn.execute(
        """
        SELECT id
        FROM assets
        WHERE source_system = ? AND source_record_id = ?
        """,
        (data["source_system"], data["source_record_id"]),
    ).fetchone()

    conn.commit()
return row[0]SQLiteのUPSERTは、一意性制約との衝突時にDO UPDATEまたはDO NOTHINGへ切り替えます。外部IDのUNIQUE制約と組み合わせれば、再実行してもレコード数を増やしません。
IDのバリデーションと正規化
IDは文字列として受け取るだけでなく、境界で規則を検証します。
import uuid


def normalize_uuid(value: str) -> str:
    if not isinstance(value, str):
        raise TypeError("IDは文字列で指定してください")

    try:
        return str(uuid.UUID(value))
    except ValueError as exc:
        raise ValueError("UUIDの形式が不正です") from exc
入力を柔軟に受け付けるか、正規形だけを許可するかはAPI契約で決めます。
次の点も明文化します。
- 大文字と小文字を同一視するか
00123と123を同じIDとして扱うか- 数値型ではなく文字列型で渡すか
- 空文字、
null、フィールド欠落をどう扱うか
特に先頭ゼロを持つIDは数値へ変換してはいけません。ExcelやCSV取り込みでも文字列として保持します。
よくある失敗
名称をIDとして使う
名称は修正、翻訳、表記統一で変わります。識別子ではなく属性として扱います。
外部IDだけを保存する
連携元が増えると同じ値が衝突します。外部IDには必ず名前空間となるsource_systemを付けます。
APIへDB連番をそのまま公開する
連番は件数や登録順を推測させ、DB統合時には衝突します。内部連番と公開IDを分ける方法がありますが、UUIDでも認可は必要です。
IDへ分類や状態を埋め込む
PUMP-ACTIVE-001のようなIDは、分類変更や状態変更で矛盾します。変わり得る情報は別フィールドへ分離します。
重複判定を全フィールド一致にする
名称や更新日時が変わると別レコードと判定されます。同一性を決めるキーと、更新される属性を分けます。
セキュリティとID
IDは認証情報ではありません。UUIDでも、サーバー側で閲覧・更新権限を確認します。
また、ログや公開データでは次を確認します。
- 外部の顧客番号や社員番号を不用意に公開しない
- UUIDv7などに含まれる時系列情報を公開してよいか確認する
- 廃棄後のIDを別対象へ再利用しない
- ID変換表へのアクセスを制限する
再利用可能なID契約として残す
ID設計は文章だけでなく、機械可読な契約へできます。
field: id
role: internal_surrogate_key
type: string
format: uuid
version: 4
nullable: false
mutable: false
case: lowercase
issued_by: receiving_system

deduplication_key:
  fields:
    - source_system
    - source_record_id
  database_constraint: unique
この定義から、JSON Schema、DB制約、Python、CSV列定義、API仕様、テストへ展開できます。CAD、図面、計算条件、部品表の参照にも同じ考え方を使えます。
まとめ
安定したデータ連携には、「IDを付ける」だけでなく、各IDの役割を分ける設計が必要です。
- 内部IDは不変のサロゲートキーにする
- 業務コードは人が使う変更可能な属性として扱う
- 外部IDは連携元との組み合わせで一意にする
- DBの
PRIMARY KEY、UNIQUE、NOT NULLで規則を強制する - 再送時は外部IDを照合してUPSERTする
- UUIDv4とUUIDv7は生成環境、並び順、公開範囲で選ぶ
- IDを認可の代わりにしない
同一性のルールをデータ契約として先に決めれば、API、DB、CSV、Python、CADデータの間で、重複や参照切れを抑えながら資産を再利用できます。