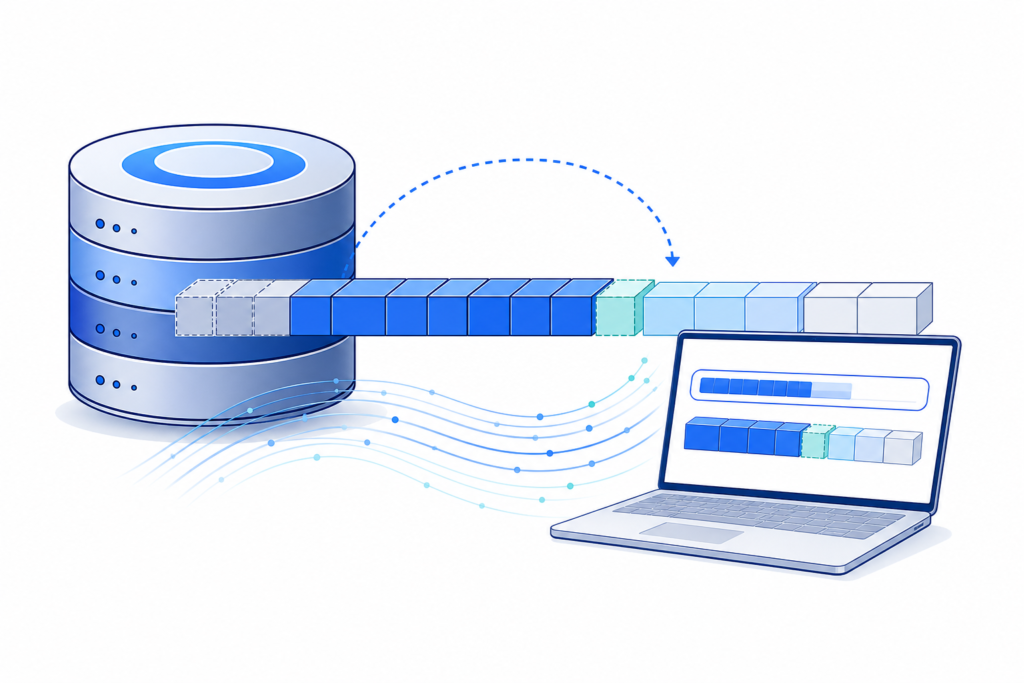
大容量のCADモデル、解析結果、バックアップ、学習用データをHTTPで取得するとき、通信が途中で切れるたびに最初から取り直すと、時間と転送量を浪費します。HTTPのRange requestを使えば、既に保存したbyteの次から取得を再開できます。
ただし、単にRange: bytes=途中位置-を付けて追記するだけでは危険です。serverがRangeを無視して全体を200 OKで返す場合や、再開前にfileが更新される場合があります。古い前半と新しい後半を結合すると、開けても内容が壊れたfileになります。
この記事では、206 Partial Content、Content-Range、If-Range、416 Range Not Satisfiableを一つの契約として扱い、安全に再開できるdownload設計を整理します。
Range requestで解決すること
Range requestは、GETで選択されたrepresentation全体ではなく、その一部分を要求する仕組みです。再開時は、途中fileの実際のsizeを次の開始offsetとして送ります。
GET /files/model-r12.step HTTP/1.1
Host: files.example.com
Range: bytes=104857600-
If-Range: "model-r12-7f3a"
Accept-Encoding: identity
Authorization: Bearer <access-token>bytes=104857600-は、0から数えて104,857,600番目のbyteから末尾までを要求します。byte位置は0始まりで、範囲の開始と終了はともに範囲へ含まれます。
HTTPのRangeはGETに対して定義されています。uploadの途中再開や、任意位置へのPUTを共通仕様として保証するものではありません。uploadは別のprotocolやAPI契約として設計します。
正常系のrequestとresponse
serverが要求を満たすと、全体ではなく一部を示す206 Partial Contentを返します。
HTTP/1.1 206 Partial Content
Content-Type: application/step
Content-Range: bytes 104857600-209715199/734003200
Content-Length: 104857600
ETag: "model-r12-7f3a"
Accept-Ranges: bytes

<104857600 bytes of binary data>Content-Rangeの各値には次の意味があります。
| 要素 | 例 | 意味 |
|---|---|---|
| unit | bytes | 範囲の単位 |
| first-pos | 104857600 | 今回のbodyの先頭offset |
| last-pos | 209715199 | 今回のbodyの末尾offset。範囲に含む |
| complete-length | 734003200 | 選択されたrepresentation全体のbyte数 |
今回のbodyに期待するbyte数は、last-pos - first-pos + 1です。clientはstatusだけでなく、開始位置、終了位置、全体size、実際に受け取ったbyte数を照合してから途中fileへ追記します。
Accept-Ranges: bytesは、対象resourceがbyte rangeを扱えることをserverが知らせるhintです。clientはこのheaderがなくてもRangeを試せます。一方、headerがあっても次回必ず206になる保証はないため、responseごとの検証は省略できません。
再開状態をfileとは別に保持する
途中fileだけでは、どの版の続きを取得すべきか判断できません。業務上の識別子とHTTP validatorをmetadataとして分けて保存します。
{
  "resource_id": "cad-model-0184",
  "revision": "R12",
  "etag": "\"model-r12-7f3a\"",
  "total_bytes": 734003200,
  "partial_bytes": 104857600,
  "sha256": "5df6e0e2761359d30a8275058e299fcc038153454f6c6a30e1d8bf178a6e7e91"
}partial_bytesは便宜的な記録であり、再開時は途中fileの実sizeを正とします。process停止直前にmetadataだけ更新され、file書込が完了していない可能性があるためです。
認証tokenや署名付きURLをmetadataへ保存しません。URLのqueryにcredentialが含まれるserviceでは、安定したresource_idから実行時に新しいURLを取得します。
If-Rangeで版の混在を防ぐ
同じURLの内容が更新され得る場合、offsetだけを送ると古い前半と新しい後半が混ざります。If-Rangeは、保存済みのvalidatorと現在のrepresentationが一致するときだけRangeを適用する条件です。
validatorが一致する
  → 206で不足部分を返す

validatorが一致しない
→ Rangeを無視し、200で現在の全体を返すclientは初回responseの強いETagを保存し、再開時に同じ値をIf-Rangeへ渡します。W/で始まる弱いETagは使えません。ETagがない場合はLast-Modifiedを使えることもありますが、RFC 9110では強いvalidatorとして扱える日時に限られます。更新されないrevision別URLやcontent hashを含むURLを用意できるなら、その方が契約を単純にできます。
重要なのは、Range付きrequestに200 OKが返ったときです。これは「続き」ではなく全体なので、既存の途中fileへ追記してはいけません。一時fileをtruncateして先頭から書き直します。
statusごとの処理を固定する
再開clientはstatus codeとheaderを組み合わせて処理します。
| status | 主な意味 | clientの処理 |
|---|---|---|
206 | 要求した部分が返った | Content-Rangeを検証し、開始位置が一致するときだけ追記 |
200 | Rangeが無視された、またはIf-Range不一致 | 途中fileを上書きして全体を保存 |
416 | 指定rangeが現在の範囲外など | Content-Range: bytes */totalとlocal sizeを比較 |
401 / 403 | 認証または認可に失敗 | credentialを更新し、bodyをfileへ書かない |
404 / 410 | 対象がない、または消失 | 自動再試行せずresource状態を確認 |
5xx | server側の一時障害の可能性 | 上限付きbackoff後に同じoffsetから再試行 |
416でContent-Range: bytes */734003200が返り、local sizeも734,003,200なら、前回のbody受信後に完了処理だけ失敗した可能性があります。最終hashを検証して完了へ移せます。local sizeが全体sizeより大きい、またはvalidatorが一致しないなら、壊れた途中fileとして隔離または再取得します。
serverはRangeを無視できるため、範囲外でも必ず416になるとは限りません。200を受け取れる設計が必要です。
PythonでContent-Rangeを検証する
次の関数は、単一byte rangeのresponseを検証します。networkやfile I/Oから分離しているため、正常系と異常系を決定的にtestできます。
import re
from dataclasses import dataclass


CONTENT_RANGE_RE = re.compile(
    r"^bytes (?P<start>\d+)-(?P<end>\d+)/(?P<total>\d+|\*)$"
)


@dataclass(frozen=True)
class PartialResponse:
    start: int
    end: int
    total: int | None

    @property
    def body_bytes(self) -> int:
        return self.end - self.start + 1


def validate_partial_response(
    status: int,
    content_range: str | None,
    requested_start: int,
) -> PartialResponse:
    if status != 206:
        raise ValueError("partial response must use status 206")
    if content_range is None:
        raise ValueError("206 response requires Content-Range")

    match = CONTENT_RANGE_RE.fullmatch(content_range.strip())
    if match is None:
        raise ValueError("invalid Content-Range")

    start = int(match.group("start"))
    end = int(match.group("end"))
    total_text = match.group("total")
    total = None if total_text == "*" else int(total_text)

    if start != requested_start:
        raise ValueError("response start does not match local file size")
    if end < start:
        raise ValueError("range end is before start")
    if total is not None and total <= end:
        raise ValueError("complete length must be greater than range end")

return PartialResponse(start=start, end=end, total=total)実際のdownload処理では、途中fileのsizeをrequested_startへ渡し、返り値のbody_bytesとstreamから実際に書いたbyte数を一致させます。不一致なら途中fileを完成扱いにせず、最後に成功したsizeから再試行します。
request headerは次のように組み立てられます。
def resume_headers(local_size: int, etag: str | None) -> dict[str, str]:
    headers = {"Accept-Encoding": "identity"}

    if local_size > 0:
        headers["Range"] = f"bytes={local_size}-"
        if etag is not None:
            if etag.startswith("W/"):
                raise ValueError("weak ETag cannot be used with If-Range")
            headers["If-Range"] = etag

    return headers
Accept-Encoding: identityは、圧縮されたbyte列と展開後のbyte列を混同しにくくするための指定です。RFC 9110では、content codingが適用されたrepresentationのRangeは符号化後のbyte列に対して計算されます。serverやintermediaryが異なるcodingを返す可能性も考え、同じvalidatorとrepresentation metadataを照合します。
fileへ安全に書き込む
完成名へ直接追記すると、別processが未完成fileを読み始める可能性があります。.partなどの一時名へ保存し、検証後に完成名へ原子的に置き換えます。
response headerを検証
  ↓
.partへ追記または200なら上書き
  ↓
書込byte数とtotal sizeを検証
  ↓
SHA-256を全体に対して再計算
  ↓
期待hashと一致したら完成名へ置換hashは途中blockだけでなく完成file全体に対して計算します。Pythonではhashlib.file_digest()を使えます。
import hashlib
from pathlib import Path


def sha256_file(path: Path) -> str:
    with path.open("rb") as file_obj:
        return hashlib.file_digest(file_obj, "sha256").hexdigest()
serverがhashを提供しない場合でも、取得側でhashを記録すれば、後続のDB登録、CAD変換、archive展開で同じfileを識別できます。ただし、改ざん検知に使う期待hashは、file本体とは別の信頼できる経路から取得します。
冪等性と再実行
GETはHTTP上で冪等ですが、localへの書込処理が自動的に安全になるわけではありません。再実行時の規則を固定します。
- 再開offsetは途中fileの実sizeから求める
- 206は開始offsetが一致した場合だけappendする
- 200は必ず一時fileを先頭から置き換える
- 同じ区間を二重にappendしないよう、書込完了後にsizeを確定する
- 完成判定はtotal sizeとhashの両方で行う
- 完成済みhashが期待値と一致するなら、同じjobを再実行しても再downloadしない
- 複数workerが同じresourceを取得しないよう、job IDやfile lockで排他する
DBにはresource_id、revision、期待hash、local path、取得済みbyte数、ETag、status、最終試行日時を分けて保存します。pathだけを一意性の根拠にせず、業務IDとversionを一意制約へ含めます。
失敗例と落とし穴
200を途中fileへ追記する
Rangeを無視した全体responseを既存fileへappendすると、前半の後ろに完全なfileが続くためsizeが過大になります。statusに応じてappendとoverwriteを分けます。
Content-Lengthだけを見る
Content-Lengthは今回のmessage bodyの長さであり、必ずしも元file全体のsizeではありません。206ではContent-Rangeのcomplete-lengthを別に確認します。
ETagを保存しない
URLとsizeが同じでも内容が変わることがあります。validatorなしで可変resourceを再開しないか、revision別のimmutable URLを使います。
offsetとbyte数を混同する
0から99までの範囲は100 byteです。end - startではなくend - start + 1で計算します。
文字列として結合する
CAD、ZIP、Parquetなどはbinary dataです。text mode、文字コード変換、改行変換を通さず、byte streamとして保存します。
セキュリティと運用
Rangeは便利ですが、多数の小さな範囲や重複範囲はserver負荷を増やします。server側ではrange数、request数、同時接続、response sizeを制限し、異常なpatternを拒否します。単純な再開では一つの連続rangeだけを要求する方が扱いやすくなります。
client側では次を守ります。
- HTTPSを使い、redirect先でも認証情報を不用意に転送しない
Authorization、署名付きURL、cookieを通常logへ残さない- response sizeに上限を設け、想定外の200でdiskを使い切らない
- 保存先を業務IDから直接組み立てず、許可したdirectory内に固定する
- hash不一致fileを完成名へ昇格しない
- retry回数、総時間、同時download数を制限する
- archiveはdownload検証後に別工程で展開し、path traversalや展開後sizeを検査する
Rangeは認証や認可を置き換えません。途中位置を知っていても、resourceへの読取権限がなければserverは拒否します。
CAD・DB・API連携へ再利用する
CAD model、点群、解析結果、BOM archiveのような大容量fileでは、file本体を業務recordへ埋め込まず、安定したasset ID、revision、media type、size、hash、取得URLをmetadataとして管理できます。
download完了後にhashをkeyとして重複排除し、DBへ取得結果を登録します。後続のCAD変換や解析jobは完成statusとhashを条件に開始し、.partを参照しません。URLが期限切れになっても、asset IDとrevisionから新しいURLを発行できれば同じ処理を再開できます。
Range、validator、hash、業務IDの役割を分けると、保存先がlocal disk、object storage、cacheのどれでも同じ契約を使えます。
まとめ
HTTP Rangeによる再開downloadは、offsetを送るだけでは安全になりません。部分responseと保存済みfileが同じrepresentationであることを検証する必要があります。
Range: bytes=<local-size>-で不足部分を要求する- byte offsetは0始まりで、開始・終了位置は範囲に含まれる
- 206では
Content-Rangeの開始位置、終了位置、全体sizeを検証する - 強いETagを
If-Rangeへ渡し、版の混在を防ぐ - 200は全体responseとして上書きし、途中fileへ追記しない
- 416ではserverの全体sizeとlocal sizeを比較する
- 一時fileへ書き、sizeとSHA-256確認後に完成名へ置き換える
- tokenや署名付きURLをmetadataとlogから分離する
この設計なら、通信断やprocess再起動が起きても取得済みbyteを再利用しつつ、古い版と新しい版を誤って結合する事故を防げます。