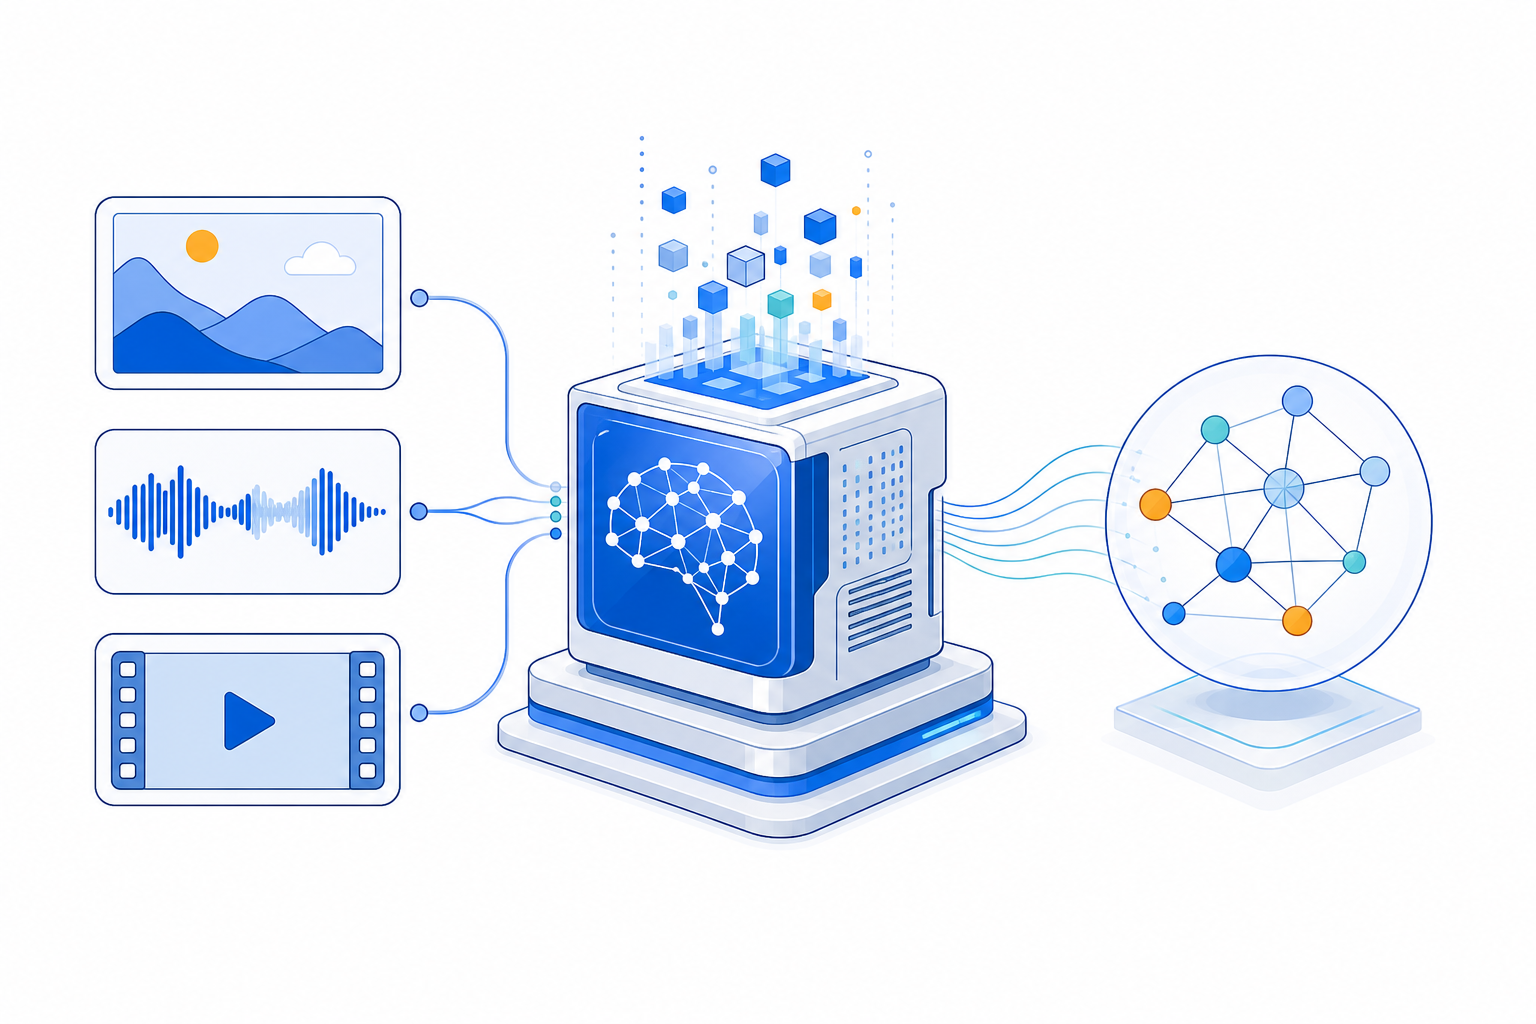
Multimodal AIという言葉を聞くと、「画像も見られるChat AI」を思い浮かべるかもしれません。
しかし、それだけではMultimodal AIの本質を捉えられません。
**modality(モダリティ)**とは、Text、Image、Audio、Videoなど、情報の形式・感覚チャネルの違いを指します。
Multimodal AIとは、異なるmodalityを一つのAIシステムで扱い、それらの関係を利用して理解・推論・生成する技術です。
2026年の重要な変化は、AIへの入力が「文章」から「現実世界を記録したデータ」へ広がっていることです。
Text
Image
Audio
Video
Document
Sensor Data
↓
Multimodal AI
↓
Understanding / Reasoning
↓
Structured Data / Text / Action
この変化は、製造業や機械設計にも大きな意味を持ちます。
図面、機械写真、計器、異音、作業動画、技術文書など、これまで人間が目や耳で確認していた情報をAIシステムへの入力として扱えるからです。
今日の到達点
この記事を読み終えると、次のことを説明できる状態を目指します。
- modalityとMultimodal AIの意味
- 「画像をLLMへ渡す」とき内部で何が必要になるのか
- Text・Image・Audio・Videoを統合する基本構造
- Multimodal AIが画像認識専用AIとどう違うのか
- 図面・機械写真・音・動画へ応用するときの限界と検証方法
Modalityとは何か
modalityは、情報を表現する形式やチャネルです。
AIで代表的なのは次のようなものです。
| Modality | 代表的な入力 |
|---|---|
| Text | 文章、コード、仕様書 |
| Image | 写真、図面、グラフ |
| Audio | 音声、機械音、環境音 |
| Video | 作業動画、設備映像 |
| Structured Data | JSON、表、DBデータ |
| Sensor | 温度、圧力、振動など |
ただし、「複数種類のファイルを受け取れる」だけでMultimodal AIになるわけではありません。
重要なのは、異なるmodality間の関係を利用できることです。
たとえば機械写真と文章を同時に渡して、
この写真の油圧配管で、
説明文にある交換対象部品はどれか?
と質問する場合、
画像内の部品
+
文章内の意味
を対応付ける必要があります。
これがmultimodalな処理です。
従来のAIは専門モデルを組み合わせていた
Multimodal以前にも画像認識や音声認識は存在しました。
たとえば、
Image
↓
Image Classifier
↓
"cat"
あるいは、
Audio
↓
Speech Recognition
↓
Text
という専用モデルです。
この方式では、処理ごとに異なるAIを組み合わせます。
画像 → Vision Model
音声 → Speech Model
文章 → Language Model
現在のMultimodal Foundation Modelでは、この境界が変わってきています。
Image ─┐
Audio ─┼→ Multimodal Model → Reasoning / Output
Text  ─┤
Video ─┘
一つのモデルまたは統合されたAIシステムの中で、複数modalityを共通の推論処理へ接続できるようになっています。
AIは画像を「文字として読む」わけではない
Text LLMは通常、文章をtokenへ変換します。
Text
↓
Tokenizer
↓
Token IDs
↓
Embedding
↓
Transformer
しかし画像には、最初から単語やtoken IDが並んでいるわけではありません。
そのため画像をモデル内部で扱える表現へ変換する処理が必要です。
概念的には、
Image
↓
Image Preprocessing
↓
Visual Encoder / Patch Representation
↓
Internal Representation
↓
Transformer / Multimodal Model
となります。
画像を小領域へ分割して表現する方式や、専用encoderを通して特徴表現へ変換する方式などがあります。
重要なのは個々の実装方式を暗記することではありません。
異なるmodalityを、モデルが計算可能な内部表現へ変換する必要がある
という原理です。
共通表現へ接続する
Multimodal AIを理解するために、次の抽象化が便利です。
flowchart TD
    T[Text] --> TE[Text Representation]
    I[Image] --> IE[Visual Representation]
    A[Audio] --> AE[Audio Representation]
    V[Video] --> VE[Temporal Visual/Audio Representation]

    TE --> M[Multimodal Reasoning]
    IE --> M
    AE --> M
    VE --> M

    M --> O[Output]
入力形式は異なりますが、最終的にはモデル内部で相互参照可能な表現へ接続されます。
たとえば、
写真中の赤いバルブという視覚情報と、
「非常停止時に閉止するバルブ」というText情報を対応付けられれば、
Image
+
Text
↓
Cross-modal reasoning
↓
回答
が可能になります。
Image Understanding
現在のMultimodal AIで最も一般的なのが画像理解です。
Google Geminiの現行公式API資料でも、TextとImageを同一interactionへ入力し、画像について説明・質問できる構造が示されています。Google AI for Developers
代表的な用途には、
- 写真の説明
- objectの識別
- document理解
- chart理解
- screenshot解析
- OCRを含む文字情報の利用
- 複数画像の比較
などがあります。
ただし、ここで重要なのが画像理解と寸法計測を混同しないことです。
写真から、
これは油圧シリンダに見えると判断できても、
ロッド径は32.00 mmであると保証できるわけではありません。
画像中に既知scaleや寸法情報がなければ、物理寸法を厳密には決定できません。
したがって工学用途では、
Visual Understanding
≠
Metrology
です。
Audio Understanding
Audioも重要なmodalityです。
現在のGemini公式資料では、Audio入力について、
- transcription
- translation
- summary
- speaker identification
- timestampを使った区間分析
などが案内されています。Google AI for Developers
機械分野で考えると、
Pump Sound
Bearing Noise
Valve Switching Sound
Cavitation-like Noise
などを入力にできる可能性があります。
しかし、ここにも重要な区別があります。
一般的なMultimodal Foundation Modelへ音を聞かせることと、
FFT
Order Analysis
Envelope Analysis
Vibration Spectrum
などによる専門的な信号解析は同じではありません。
たとえば周波数解析では、離散時間信号 $x[n]$ に対するDFTを概念的に、\[ X[k] = \sum_{n=0}^{N-1} x[n] e^{-j2\pi kn/N} \]
として計算できます。
これは決定論的な信号処理です。
Multimodal AIに「異音があるように聞こえる」と判断させることと、FFTから特定周波数成分を定量評価することは別の処理です。
実務では、
Audio
├─ Multimodal AI → 意味・状況理解
└─ Signal Processing → 周波数・振幅解析
と分離した方が安全です。
Video Understanding
Videoはさらに複雑です。
Videoには、
Image
+
Time
+
Audio
が含まれるからです。
つまり、一枚の画像を見るだけではなく、
Frame 1
↓
Frame 2
↓
Frame 3
↓
...
という時間変化を扱う必要があります。
Google Geminiの現行APIでは、動画のvisual streamとaudio streamを処理し、内容説明やtimestampを指定した質問が可能です。Google AI for Developers
ここで非常に重要な実装上の注意があります。
動画AIが必ずしも全フレームをそのまま精密に見ているわけではありません。
Geminiの現行公式資料では、static processingのデフォルトで動画から1 FPSでframeを抽出すると説明されています。この方式では高速な動作や短時間だけ発生する現象を取り逃がす可能性があります。Google AI for Developers
たとえば、
0.15秒だけ発生したバルブの異常動作を1 FPS samplingで確実に検出できるとは限りません。
したがって、
動画を入力できる
=
すべての瞬間を観測している
ではありません。
Multimodal AIはSensor Fusionと同じではない
工学分野ではSensor Fusionという言葉があります。
たとえばrobotでは、
Camera
LiDAR
Encoder
IMU
Force Sensor
を統合します。
Multimodal AIも複数情報源を扱いますが、Sensor Fusionと完全に同義ではありません。
制御系のSensor Fusionでは、
- sampling frequency
- timestamp synchronization
- calibration
- coordinate transformation
- uncertainty
- sensor noise
などが非常に重要です。
一方、Multimodal Foundation Modelは意味理解や推論を得意とします。
したがって、
Raw Sensor
↓
Signal Processing / Sensor Fusion
↓
Structured State
↓
Multimodal AI
↓
Reasoning
という役割分担も有効です。
AIへ生データを全部投げれば、従来の信号処理や計測工学が不要になるわけではありません。
工学データをMultimodal AIへ接続する
機械設計・製造分野では、次のような入力を考えられます。
図面
機械写真
仕様書
部品表
測定データ
異音
作業動画
保全記録
これらを単独で扱うより、相互に接続すると価値が高まります。
たとえば設備トラブルなら、
flowchart TD
    P[Machine Photo] --> AI[Multimodal AI]
    A[Machine Audio] --> AI
    D[Manual / Drawing] --> AI
    H[Maintenance History] --> AI

    AI --> C[Candidate Causes]
    C --> V[Engineering Verification]
    V --> R[Maintenance Decision]
写真だけなら、
「この部品が破損しているように見える」
までです。
しかし、
写真
+
異音
+
油圧回路図
+
過去の故障履歴
を組み合わせれば、より文脈のある候補を生成できます。
ただし最終診断をAIだけで確定してはいけません。
図面理解で何ができるか
設計図面はMultimodal AIにとって興味深い入力です。
図面には、
- geometry
- dimension
- symbol
- text
- annotation
- spatial relationship
が混在しています。
一般的な写真より情報密度が高く、1 pixelや1文字の誤読が設計判断へ影響します。
そのため、
Drawing Image
↓
Multimodal AI
↓
設計情報
だけでは不十分です。
実務では、
Drawing
↓
AI Extraction
↓
Structured Data
↓
Schema Validation
↓
Engineering Rule
↓
Human Review
とする方が堅牢です。
たとえばAIが、
{
  "component": "hydraulic_cylinder",
  "bore_mm": 80,
  "rod_mm": 45,
  "stroke_mm": 300
}
と抽出したとしても、
JSONとして正しいことと、図面を正しく読めたことは別です。
必要なのは、
Syntax Validation
↓
Schema Validation
↓
Drawing Cross-check
↓
Engineering Validation
です。
Multimodal AIの失敗モード
Multimodal AIにはTextだけのLLMとは異なる失敗モードがあります。
小さい文字を誤読する
図面、銘板、計器などでは小さい文字が重要です。
画像圧縮や解像度不足によって、
32を、
82と誤認すれば、工学的には重大な差になります。
空間関係を誤る
画像内に複数の部品がある場合、
左のバルブ
右のバルブ
上側配管
下側配管
の対応を誤る可能性があります。
見えていない部分を補完する
LLMのhallucinationと同様、画像でも不明瞭な部分についてもっともらしい説明を生成する可能性があります。
動画samplingで瞬間現象を逃す
frame sampling方式では、高速現象を見逃す可能性があります。
Audioの意味理解と計測を混同する
「異音らしい」という分類と、「3.2 kHzに異常ピークがある」という定量計測は別です。
評価はmodalityごとに分ける
Multimodal systemを一つの総合scoreだけで評価すると、問題点を発見しにくくなります。
たとえば図面読取りシステムなら、
| 評価対象 | 評価例 |
|---|---|
| Text | 文字認識率 |
| Dimension | 寸法値一致率 |
| Symbol | 記号分類精度 |
| Relation | 寸法と対象形状の対応 |
| Extraction | JSON Schema適合率 |
| Engineering | 設計ルール判定精度 |
のように分解できます。
動画なら、
Object Detection
Temporal Event Detection
Audio Recognition
Timestamp Accuracy
Reasoning Accuracy
を分けます。
Multimodalであるほど、評価も分解する必要があります。
CostとLatency
Multimodal入力はTextより情報量が大きくなりやすい傾向があります。
高解像度画像、多数ページのPDF、長時間Audio、Videoを扱えば、
Data Size
↑
Processing
↑
Latency
↑
Cost
↑
となる可能性があります。
したがって「全部AIへ送る」設計が最適とは限りません。
たとえば動画なら、
3時間動画
↓
そのまま全投入
ではなく、
Sensor / Event Detection
↓
異常候補区間を抽出
↓
30秒Clip
↓
Multimodal AI
と前処理する方法があります。
AIへ渡す前に情報量を減らすことも、システム設計の一部です。
PrivacyとSecurity
Multimodal AIでは、Text以上にprivacyへ注意する必要があります。
写真や動画には、意図していなくても、
- 人物
- 顔
- PC画面
- ホワイトボード
- 顧客名
- 図面番号
- 工場layout
- 製造設備
- 未公開製品
などが映り込む可能性があります。
したがって企業利用では、
Input
↓
Classification
↓
Mask / Redaction
↓
AI
という前処理も検討します。
「写真1枚だから機密ではない」とは限りません。
Multimodal AIと専門ツールを競合させない
Multimodal AIの価値は、CAD、画像処理、信号処理、計測ソフトを置き換えることだけではありません。
むしろ、
Multimodal AI
→ 意味理解・候補生成

Computer Vision
→ 画像計測

Signal Processing
→ 周波数解析

CAD
→ 幾何情報

Python
→ 数値計算

Database
→ 正式データ

Engineer
→ 妥当性判断
という役割分担が重要です。
たとえば写真からボルトを見つけるのはAIでも、正確な座標や径を取得できるCADデータがあるなら、CADを使う方が確実です。
AIは既存の工学ツールをすべて代替するのではなく、異種データ間を意味的につなぐ層として使うと強力です。
Multimodal Engineering Systemという考え方
ここまでをまとめると、工学向けMultimodal AIは次のようなarchitectureとして考えられます。
flowchart TD
    A[Drawing / Photo / Video / Audio] --> B[Preprocessing]
    B --> C[Multimodal Model]
    C --> D[Structured Extraction]
    D --> E[Engineering Data Model]
    E --> F[Rules / Calculation / CAD / DB]
    F --> G[Verification]
    G --> H[Engineer Approval]
重要なのは中央のAIだけではありません。
前段には、
Preprocessingがあり、後段には、
Structured Data
Rules
Calculation
Verification
があります。
この構造なら、将来モデルを交換しても、工学データや設計ルールを再利用できます。
Multimodal AIの本当の価値
Text AIでは、人間が現実世界の情報を一度文章へ変換する必要がありました。
Machine
↓
Human observes
↓
Human writes text
↓
AI
Multimodal AIでは、この境界を短縮できます。
Machine
↓
Photo / Audio / Video / Drawing
↓
AI
これは大きな変化です。
しかし、AIへ現実世界を直接接続できるほど、入力品質と検証責任も重要になります。
写真が不鮮明なら判断も不安定になります。
Audioのsampling条件が悪ければ、重要な周波数情報を失います。
Videoのframe rateが不足すれば、瞬間現象を逃します。
つまり、
Multimodal AIの性能はモデルだけでなく、観測系の品質にも依存する
ということです。
これは工学では非常に自然な考え方です。
測定器が悪ければ、解析器だけ高性能にしても正しい結果は得られません。
まとめ
Multimodal AIは、「画像を見られるLLM」というだけの技術ではありません。
本質は、
Text
Image
Audio
Video
↓
Internal Representation
↓
Cross-modal Reasoning
↓
Output / Actionという、異なる情報形式を共通の問題解決へ接続する仕組みです。
2026年現在、実用システムでは画像、音声、動画をFoundation Modelへ直接入力できる範囲が大きく広がっています。Googleの現行Gemini APIだけを見ても、Image、Audio、Videoをそれぞれ公式に扱っています。Google AI for Developers
しかし、
AI Vision
≠
Metrology

AI Audio Understanding
≠
Signal Analysis

Video Understanding
≠
全フレームの完全観測
です。
工学用途では、
Multimodal AI
+
Structured Data
+
Signal Processing
+
Calculation
+
Engineering Rules
+
Verification
として組み合わせる必要があります。
そしてMultimodal AIの最大の価値は、既存の工学技術を消すことではありません。
図面・写真・音・動画・文章という分断されていた情報を、意味のレベルで接続できることです。
この能力が、次のAI Coding、AI Agent、Physical AIへつながっていきます。
参考情報
- Google Gemini API:Image understanding
- Google Gemini API:Audio understanding
- Google Gemini API:Video understanding
- Google Gemini API:Video technical details
- Meta AI Research:vision・audition・languageを扱うTRIBE v2
今日の確認問題/学習課題
- Image Understandingと画像計測の違いを説明してください。特に「写真から部品を認識できること」と「その部品の寸法を保証できること」がなぜ別なのかを整理します。
- 機械設備を一つ選び、
Text / Image / Audio / Video / Sensorのうち利用可能なmodalityを列挙し、それぞれから何を取得できるか整理してください。 - 異音診断について、
Multimodal AIが担当する処理とFFTなどの決定論的信号処理が担当する処理を分離してください。 - 図面からAIで寸法情報をJSON化すると仮定し、
AI抽出 → Schema検証 → 工学検証 → 人間承認の各段階で何を確認すべきか考えてください。