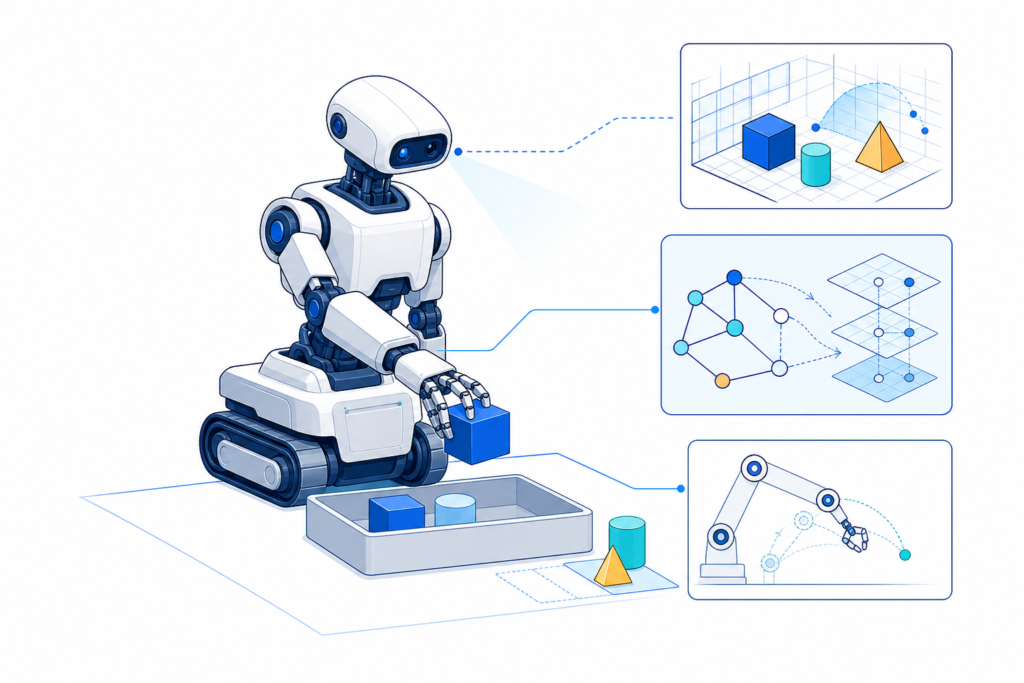
今日の到達点
- Physical AI、Embodied AI、ロボティクス基盤モデル、VLM、VLA、World Modelの役割を区別できる。
- 認識・状態推定・計画・制御・駆動を一つのシステムとして説明できる。
- シミュレーションと実機データの役割、Sim-to-Realの難しさを理解する。
- 安全、遅延、決定論的制御、力制御の責任境界を設計できる。
- 機械設計・油圧・センサー技術とAIの接点を具体化できる。
はじめに:AIが「答える」から「動かす」へ
文章や画像を生成するAIと、実世界の物体をつかむロボットでは、成功の意味が異なる。文章の誤りは訂正できることが多い。しかし、ロボットの誤動作は衝突、落下、設備損傷、人身事故につながり得る。
Physical AI(フィジカルAI)は、AIが物理環境を観測し、状態を推定し、行動を選び、実機または物理的なシミュレーション環境へ作用する技術領域を指す。重要なのは「AIを搭載したロボット」という製品名ではなく、学習による判断と、物理法則に従う機械・制御系をどう接続するかという設計課題である。
対象は人型ロボットに限らない。産業用マニピュレータ、移動ロボット、検査装置、建設機械、専用の自動化設備にも同じ論点が現れる。
用語を整理する:何を学習し、何を出力するのか
| 用語 | 主な役割 | 典型的な出力 | 注意点 |
|---|---|---|---|
| Physical AI | 物理世界で認識・推論・行動する技術全般 | 行動方針や機械への指令 | 単一のモデル名ではない |
| Embodied AI | 身体・センサー・環境との相互作用を伴う知能 | 環境に適応した行動 | 身体の構造が能力を左右する |
| Robotics Foundation Model | 多様なロボットデータから汎用能力を学ぶ基盤モデル | 状態表現、行動、方針など | すべての機体でそのまま動くとは限らない |
| VLM | Vision-Language Model。視覚と言語を結ぶ | 説明、認識結果、計画 | モーター指令の生成は必須でない |
| VLA | Vision-Language-Action。視覚・言語から行動を導く | 関節目標、動作系列など | 出力を安全に実行する下位系が必要 |
| World Model | 行動後の環境変化などを予測するモデル | 将来状態、映像、予測結果 | 物理的な厳密性は別途検証する |
VLMとVLAの決定的な違い
VLMは、カメラ画像を見て「赤い箱は棚の右側にある」と答えたり、「箱を移動する順序」を提案したりする。一方、VLAは観測と指示を受け、ロボットが実行可能な行動表現を生成する。行動表現はモデルや機体によって異なり、関節位置目標、手先の姿勢、一定時間分のアクション列などがある。
ここでいうActionは、必ずしも電磁弁への電流指令やサーボアンプの最終トルク指令ではない。モデル出力と実際のアクチュエータ駆動の間に、運動学・軌道補間・フィードバック制御・安全監視が入る設計が一般的に重要となる。
World Modelは万能な物理シミュレータではない
World Modelは「この操作をしたら次に何が起こるか」を学習的に予測する仕組みである。画像生成型、潜在状態予測型、行動条件付き予測型など実装は多様だ。
Google DeepMindが2025年8月に発表したGenie 3は、操作可能な仮想環境を生成するWorld Modelの例である。ただし、映像として自然に見えることと、接触力、摩擦、油圧過渡応答まで設計精度で再現することは同義ではない。機械強度や安全性の根拠には、妥当性確認済みの解析・実測を用いる。
Physical AIのシステム構造
次の図は、特定メーカーに依存しない概念的な構成である。AIは全層を置き換えるのではなく、上位の認識・計画・行動生成を担い、下位の制御系と連携する。
flowchart TD
    A["Task / Instruction"] --> B["Perception"]
    S["Camera / Force / Position Sensors"] --> B
    B --> C["State Estimation / World Model"]
    C --> D["Planning / VLM"]
    D --> E["Action Policy / VLA"]
    E --> F["Trajectory / Control"]
    F --> G["Actuator / Mechanism"]
    G --> H["Physical Environment"]
    H --> S
    I["Independent Safety Layer"] -.-> F
    I -.-> G
Perception:センサー情報を意味ある観測へ
カメラ、LiDAR、深度センサー、エンコーダ、力覚センサー、圧力センサーなどから情報を取得する。物体の識別だけでなく、座標系、校正誤差、遮蔽、照明変動、センサー故障を扱う必要がある。
State Estimation:機械の現在状態を推定する
「箱が見える」ことと「箱を安全につかめる」ことは違う。手先位置、関節角、速度、接触状態、把持力、対象物の姿勢などを統合する。ここで不確かさを無視すると、上位AIの計画がもっともらしくても実機では失敗する。
PlanningとAction Policy:目的を動作へ変える
Planningは「どの順序で何をするか」を決める。VLAなどのAction Policyは、観測と目標から具体的な動作候補を出す。両者を一つのモデルで実装する場合も、複数モデルに分ける場合もある。生成した軌道が関節可動域、障害物、把持条件を満たすか、実行前・実行中に確認する。
ControlとActuation:物理的な運動を成立させる
サーボ制御、位置・速度・力のフィードバック、モーターや油圧弁の駆動、機構の応答を扱う。制御周期、最大速度、加速度、力、圧力、温度などの制約は、言語モデルの判断だけに任せない。
安全関連の停止・制限機能は、生成AIとは独立して要求性能を満たす設計と検証が必要である。図のSafety Layerは概念上の独立経路であり、実装時にはリスクアセスメントに応じた安全回路・安全制御を選定する。
2026年の代表的な技術アプローチ
Google DeepMind:高位の推論とVLAの分担
2025年9月公表のGemini Robotics 1.5では、空間理解や計画を担うGemini Robotics-ER 1.5と、行動を生成するGemini Robotics 1.5の役割分担が示された。2026年4月公表のGemini Robotics-ER 1.6では、計器の読み取り、複数視点での理解、作業完了判定などの能力が説明されている。公開情報では、ER 1.6はGemini APIを通じて開発者が利用できる一方、VLA系モデルの利用条件はモデルごとに異なる。
2026年7月公開のGemini Robotics On-Device 2のモデルカードは、入力を文章・画像・ロボットの自己状態、出力を数値的なロボット行動と明記し、提供先を選定されたテスターとしている。オンデバイス実行は通信依存を減らす設計選択肢だが、遅延と安全性が自動的に保証されるわけではない。
NVIDIA:モデルと開発パイプラインの統合
2026年7月の公式技術記事では、Isaac GR00T 1.7が画像・言語・ロボット状態を入力とするVLAモデルとして紹介され、公開ウェイトとApache 2.0ライセンスが説明されている。同時にIsaac Lab-Arena、遠隔操作データ収集、学習、シミュレーション評価、配備をつなぐ開発フローが示された。
重要なのはモデル単体の性能より、データ取得→後学習→閉ループ評価→実機導入を再現できる点である。ただし公開モデルであっても、対象機体への適合、制御系との統合、安全認証が完了していることを意味しない。
Physical Intelligence:異なる環境への汎化
研究論文『π0.5: a Vision-Language-Action Model with Open-World Generalization』(2025年)は、複数ロボットのデータ、ウェブ由来データ、言語指示、サブタスク情報を組み合わせ、新しい家庭環境での操作タスクへの汎化を検討した。ここで問われるのは、学習時に見ていない物体・配置・環境でも作業を続けられるかである。
これらの成果は研究・製品開発の重要な例だが、紹介動画や限定条件の評価を、無人の長時間運用や量産設備での稼働保証と同一視してはいけない。
学習データ、シミュレーション、Sim-to-Real
ロボットの学習では、文章だけでは十分でない。カメラ画像とともに、時刻同期された関節状態、操作指令、力、接触、成否、環境条件などが必要になる。
| データ源 | 強み | 主な弱点 |
|---|---|---|
| 実機の操作記録 | 実際の摩擦・遊び・遅れを含む | 収集コストと事故リスクが高い |
| 人間による遠隔操作 | 成功動作を教示しやすい | 操作者の癖や対象機体への依存 |
| 物理シミュレーション | 危険条件を反復評価できる | モデル誤差が実機へ持ち込まれる |
| 合成画像・合成動作 | 条件を広く変化させられる | 現実の分布を十分に覆うとは限らない |
Sim-to-Realは、シミュレーションで学んだ動作を実機へ移す問題である。接触剛性、摩擦係数、バックラッシ、油の温度による粘度変化、センサー遅延、弁の不感帯などが差を生む。
検証では、対象物の質量・寸法、初期位置、照明、外乱、機械摩耗などを変え、条件ごとに失敗率を記録する。シミュレーションの成功率だけで実用性を判断せず、実機の閉ループ試験へ段階的に進む。
機械設計・油圧・センサーとの接点
油圧アクチュエータ:AIの指令は力学制約を超えられない
油圧シリンダの理想的な推力は、圧力差と有効受圧面積から概算できる。簡略化した一方向の例では、損失を係数で表すと $F \approx \Delta p A \eta$ となる。$F$ は推力(N)、$\Delta p$ は有効圧力差(Pa)、$A$ は有効面積(m²)、$\eta$ は概算の効率係数である。
ただし複動シリンダではロッド側面積が異なり、背圧、摩擦、負荷方向、動的な圧力変動も考慮する。AIが「この位置まで動かす」と判断しても、必要推力、速度、流量、保持力を満たすかは別問題だ。
センサー:認識と制御の間を数値でつなぐ
カメラでワークを認識し、位置センサーでストロークを測り、圧力センサーから負荷の変化を推定する構成を考える。圧力だけから接触力を正確に求めることは難しいため、機構摩擦や圧力損失、力覚センサーの追加要否を評価する。
取得データには単位、座標系、タイムスタンプ、校正日、精度、異常値フラグを持たせると、学習・解析・保守へ再利用しやすい。
機械部品:AI以前に成立させるべき条件
減速機、軸受、シール、配管、ホース、継手、エンドエフェクタは、荷重、寿命、剛性、漏れ、許容温度、保守性に制約される。動作方針が賢くなっても、部品の定格や規格適合性は変わらない。
設計の入口として、AIへ渡す前に可動域・最大荷重・速度・圧力・温度・停止条件を機械可読な制約として定義する方法が有効である。
実務導入で避けられない四つの課題
Safety:安全は「モデルの賢さ」と別に証明する
人の立入り、挟まれ、落下、予期しない再起動、通信断、電源喪失、油圧残圧などを危険源として評価する。産業ロボットにはISO 10218-1:2025(ロボット本体)とISO 10218-2:2025(用途・セル統合)が重要な参照先となる。ただし適用範囲には除外があり、移動ロボットや特殊用途へ無条件に適用できるわけではない。
Latency:平均速度より最悪時の遅れを見る
カメラ取得、推論、通信、軌道生成、制御、機械応答の遅れが累積する。評価対象は平均推論時間だけでなく、遅延分布の上側、周期超過、通信断時の振る舞いである。クラウド推論を使う場合、ネットワークの変動を制御系へ直接持ち込まない構成を検討する。
Determinism:制御周期を守る
生成AIの処理時間は一定とは限らない。一方、低位の制御ループは定めた周期内で処理を終える必要がある。ROS 2のros2_control公式文書も、制御ループのジッタ低減と実時間実行を重視している。上位AIが動作目標を更新し、下位の決定論的な制御器が周期実行するという分離は、検討すべき基本構造だ。
Force Control:接触は位置だけで決まらない
把持、組付け、研磨、押付けでは力・トルクの監視が必要になる。位置だけを正確に追従しても、対象物の寸法差や剛性差によって過大な接触力が生じる。力制御、インピーダンス制御、機械的コンプライアンス、過負荷保護を組み合わせ、故障時の安全側動作を設計する。
導入を評価するための検証表
| 評価項目 | 測るもの | 最低限記録する条件 |
|---|---|---|
| タスク成功率 | 定義した完了条件の達成割合 | 試行数、対象物、初期配置 |
| 汎化性能 | 未学習条件での成功率 | 新規物体、照明、摩擦、配置 |
| 遅延と周期 | 推論時間、ジッタ、周期超過 | ハードウェア、負荷、通信状態 |
| 物理的妥当性 | 力・速度・圧力・温度の逸脱 | センサー校正、許容範囲 |
| 安全性 | 危険状態への遷移と保護動作 | 故障注入、停止時間、リスク評価 |
| 運用性 | 復旧時間、介入回数、保守負荷 | 連続稼働時間、作業者の介入基準 |
実機評価は、空運転→低速・低負荷→制限付き実作業→条件拡張の順で進める。統計上の成功率が高くても、稀な重大事故のリスクが許容されるとは限らない。ベンチマークを比較するときは、ロボット機体、タスク、データ分割、試行回数、成功判定、介入条件を揃える。
小さく始める:設備点検ロボットの設計例
最初から「汎用ロボットが何でも行う」を目指す必要はない。例えば、設備の圧力計を撮影し、指示値を読み取り、点検記録へ転記する読み取り支援から始められる。
入力は計器画像と設備ID。VLMが目盛り・針・単位を推定し、画像処理やルールで範囲を照合する。出力は「推定値・単位・信頼度・画像参照・要確認フラグ」とする。安全上重要な判断や弁操作は自動化せず、別の承認・制御系へ渡す。
次の段階で、カメラ位置決めを行う移動機構やマニピュレータを加える。AIの担当はどの計器をどの順で確認するか、従来制御の担当は安全な移動と停止、人間の担当は異常判断と運用承認と切り分ける。
今日の確認問題・学習課題
- VLMとVLAの出力の違いを説明し、VLA出力をそのまま油圧弁へ送らない理由を述べよう。
- 上のMermaid図を自分の言葉で描き直し、Perception、Planning、Control、Actuationの担当機能を記入しよう。
- 油圧シリンダ、圧力センサー、エンドエフェクタの三つについて、AIへ渡す情報と機械・制御側で守る制約を整理しよう。
- シミュレーションで成功した把持動作が実機で失敗する原因を三つ挙げ、各原因の検証方法を考えよう。
まとめ
Physical AIの本質は、生成AIが機械制御をすべて代替することではない。学習による認識・計画・行動生成を、センサー、制御器、アクチュエータ、機械設計、安全機構と統合することにある。
VLA、World Model、ロボティクス基盤モデルはそのための重要な技術だが、実用性を決めるのは実機での再現性、制約遵守、異常時の安全性、保守可能性である。特に油圧・機械・制御の知識は、AI時代にも物理世界の成立条件として残る。
参考情報(2026年10月13日確認)
- Google DeepMind:Gemini Robotics 1.5(2025年9月25日)
- Google DeepMind:Gemini Robotics-ER 1.6(2026年4月14日)
- Google DeepMind:Gemini Robotics On-Device 2 Model Card(2026年7月30日)
- Google DeepMind:Genie 3(2025年8月5日)
- NVIDIA:Isaac GR00T 1.7開発フロー(2026年7月7日)
- Physical Intelligence:π0.5技術論文(2025年)
- ros2_control:Controller Managerと実時間制御
- ISO 10218-1:2025:Industrial robots
- ISO 10218-2:2025:Robot applications and robot cells