バックアップは「ファイルがある」だけでは成立しない
SQLiteは1ファイルで扱えるため、稼働中の.dbをそのままcopyすればバックアップになるように見えます。しかし、copy中に書き込みtransactionが進むと、copy先に古いpageと新しいpageが混在するおそれがあります。WAL modeでは、確定済みデータが-walに残っている場合もあります。
安全なバックアップとは、ある時点で整合し、実際に復元できるsnapshotです。必要な条件は次のとおりです。
- 元databaseと別の保存先へ退避されている
- 物理構造、参照関係、schema versionを検査できる
- 必須tableや代表queryを確認できる
- 再実行しても正常な世代を上書きしない
- 隔離環境で復元testを実施している
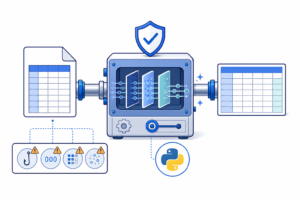
この記事ではSQLite Online Backup APIを使い、Pythonで「取得→検証→確定→復元確認」までを一つの契約として設計します。
生file copyが危険になる理由
SQLiteはdatabase本体のほか、transaction処理中にrollback journalやWALを使います。稼働中の本体だけをOSのcopy commandで複製すると、copy開始時と終了時でpageの内容が変わる可能性があります。障害後に-journalや-walを本体から切り離すと、SQLiteが自動回復に必要な情報を失うこともあります。
Online Backup APIはSQLite自身がconnectionを通してpageを読み、destination databaseへcopyします。処理を分割できるため、sourceを長時間lockし続けず、稼働中でも整合したsnapshotを作れます。Python標準libraryのsqlite3.Connection.backup()から利用できます。
方式を目的で選ぶ
| 方式 | 出力 | 主な用途 | 注意点 |
|---|---|---|---|
| Online Backup API | SQLite database | 稼働中DBの定期snapshot | lock競合、容量、完了後検証が必要 |
VACUUM INTO | 最適化済みSQLite database | compactなcopy | CPU負荷が増え、incremental実行できない |
.dump / iterdump() | SQL text | 内容確認、移行補助 | 復元時間と拡張機能の再現を確認する |
| 停止後のfile copy | DBと必要なjournal | 全接続を停止できる保守作業 | 稼働中copyへ流用しない |
VACUUM INTOは論理内容が同じcompactなdatabaseを作り、削除済み領域も除去します。一方、Backup APIはCPU消費が比較的小さく、page単位で進められます。「稼働中snapshot」「最小size」「SQLによる可搬性」のどれが必要かを先に決めます。
入力と出力の契約
backup jobの入力には、source識別子、実行を一意にするbackup_id、期待するschema version、必須table、destination、保管期限を含めます。
出力はSQLite fileとmanifestに分けます。manifestにはbackup_id、取得日時、byte数、SHA-256、schema version、検査結果を記録し、tokenやpassword、個人情報は複製しません。
{
  "backup_id": "parts-db-20261022T043100Z",
  "created_at": "2026-10-22T04:31:00Z",
  "database": "parts.db",
  "schema_version": 7,
  "size_bytes": 184320,
  "sha256": "<64 lowercase hexadecimal characters>",
  "integrity_check": "ok",
  "foreign_key_violations": 0
}
hashは転送後の破損検出には使えますが、正しいsourceを取得した証明にはなりません。schema version、必須table、業務件数、復元testを別に確認します。
一時fileで作り、検証後に確定する
最終fileへ直接backupすると、disk fullやprocess停止の際、不完全なfileを成功品と誤認するおそれがあります。次の順序にします。
- final destinationと同じdirectoryへ一時fileを作る
- Online Backup APIで一時fileへcopyする
- connectionを閉じ、一時fileをread-onlyで検査する
- 合格後にfinal nameへrenameする
- hashとmanifestを作り、backup catalogへ成功を記録する
同じfilesystem内のrenameなら原子的に扱いやすくなります。final名にはUTC時刻やrun IDを含め、既存世代を上書きしません。期限切れ世代の削除はbackup作成とは別のjobにします。
PythonでOnline Backup APIを実装する
次の例はsourceをread-onlyで開き、一時fileへbackupし、検証後にfinal nameへ切り替えます。pagesは1回にcopyするpage数、sleepは残りを再試行するときの待機時間です。最適値はdatabase sizeと書き込み負荷を測って決めます。
from __future__ import annotations

import os
import sqlite3
import tempfile
from pathlib import Path


def validate_backup(
    path: Path,
    required_tables: set[str],
    expected_user_version: int,
) -> None:
    uri = f"{path.resolve().as_uri()}?mode=ro"
    with sqlite3.connect(uri, uri=True) as conn:
        result = conn.execute("PRAGMA integrity_check").fetchall()
        if result != [("ok",)]:
            raise RuntimeError(f"integrity_check failed: {result}")

        violations = conn.execute("PRAGMA foreign_key_check").fetchall()
        if violations:
            raise RuntimeError(f"foreign key violations: {violations}")

        version = conn.execute("PRAGMA user_version").fetchone()[0]
        if version != expected_user_version:
            raise RuntimeError(f"unexpected schema version: {version}")

        tables = {
            row[0]
            for row in conn.execute(
                """
                SELECT name FROM sqlite_schema
                WHERE type = 'table' AND name NOT LIKE 'sqlite_%'
                """
            )
        }
        missing = required_tables - tables
        if missing:
            raise RuntimeError(f"missing tables: {sorted(missing)}")


def create_verified_backup(
    source: Path,
    destination: Path,
    required_tables: set[str],
    expected_user_version: int,
) -> None:
    source = source.resolve()
    destination = destination.resolve()
    destination.parent.mkdir(parents=True, exist_ok=True)

    if source == destination:
        raise ValueError("source and destination must differ")
    if destination.exists():
        raise FileExistsError(destination)

    handle, name = tempfile.mkstemp(
        prefix=f".{destination.name}.",
        suffix=".partial",
        dir=destination.parent,
    )
    os.close(handle)
    temp_path = Path(name)

    try:
        source_uri = f"{source.as_uri()}?mode=ro"
        with sqlite3.connect(
            source_uri, uri=True, timeout=10.0
        ) as src, sqlite3.connect(temp_path, timeout=10.0) as dst:
            src.backup(dst, pages=256, sleep=0.1)

        validate_backup(
            temp_path,
            required_tables,
            expected_user_version,
        )
        os.chmod(temp_path, 0o600)
        temp_path.rename(destination)
    except Exception:
        temp_path.unlink(missing_ok=True)
        raise
PRAGMA user_versionはapplicationがschema versionの整数を保存できる領域です。migrationを自動管理する機能ではないため、番号とmigration履歴はapplication側で管理します。
同名jobが複数processで走る構成では、backup catalogの一意制約や排他制御も必要です。object storageへ送る場合は、localで完成品を作ってからuploadし、remote側のversion IDとhashを記録します。
正常系と異常系を検証する
物理整合性と参照整合性
PRAGMA integrity_checkはpage、record、index、UNIQUE、CHECK、NOT NULLなどを検査し、問題がなければokを返します。ただし外部キー違反は対象外なので、PRAGMA foreign_key_checkを別に実行します。
大規模databaseで毎回の完全検査が重い場合、日次はquick_check、定期的にintegrity_checkという段階化もできます。ただしquick_checkはindex内容とtable内容の一致やUNIQUE制約など一部を省略します。検出範囲を運用手順へ明記します。
論理整合性
物理的に正常でも、空のdatabaseや別環境のdatabaseを取得した可能性があります。必須table、schema version、重要record数、最新更新時刻を確認します。稼働中sourceの現在件数との完全一致ではなく、完成snapshot内部で成立すべき条件を検証します。
復元test
backup成功の最終判定は、別pathへ復元して必要なqueryを実行できることです。本番へ上書きせず、隔離環境で次を確認します。
- read-onlyで開ける
- schema versionとapplication versionが対応する
- 代表queryが期待する列と型を返す
- 主要recordをIDで取得できる
- 外部キーと業務上の集計が成立する
- 復元所要時間が許容停止時間内に収まる
冪等性・世代管理・security
backup_idをcatalogの一意keyにし、状態をrunning、verified、failedへ分けます。verified済みのIDなら結果を再利用し、failedなら新しい一時fileからやり直します。失敗時はpartial fileをfinal名で残さず、成功catalogも書きません。
保存先容量不足、permission error、database lock、process停止を異常系testに含めます。retentionは日次・週次・月次などの回復点を残し、sourceと同じdiskだけへ保存しません。異なる権限、別storage、immutableなversionを組み合わせ、backup jobのcredentialは最小権限にします。
API・CAD・設計データへ再利用する
SQLiteをCAD属性、BOM、検査記録、API cacheに使う場合、manifestへapplication version、schema version、CAD revision、単位系、座標系、外部ID対応表のversionを残します。
SQLite外のCAD fileや画像はBackup APIではcopyされません。databaseが参照する外部assetを同じ回復点へそろえるには、version付きobjectやcontent hashで整合点を作ります。database backupだけでsystem全体を復元できると誤解しないことが重要です。
よくある失敗
- 稼働中の
.dbだけをcopyする:Backup APIかVACUUM INTOを使い、journalを手作業で分離しない。 - 作成時点で成功にする:一時fileへ作り、検査と復元test後に確定する。
integrity_checkだけで十分と考える:foreign_key_checkと業務条件を追加する。- 同じfile名を上書きする:一意な
backup_idと世代管理を使う。 - sourceと同じdiskだけへ保存する:別storage、別権限、retentionを設計する。
- database外のassetを忘れる:CAD fileや添付fileもversionとhashで結ぶ。
まとめ
SQLiteのバックアップはfile複製ではなく、復元可能なデータ契約です。稼働中databaseにはOnline Backup APIを使い、一時fileへ整合snapshotを作ります。その後、integrity_check、foreign_key_check、schema version、必須table、代表queryを確認し、合格したfileだけを正式な世代として保存します。
backup ID、hash、manifest、retention、別storage、復元演習を組み合わせれば、「いつの何を、どのversionで、何分で戻せるか」を答えられる状態になります。