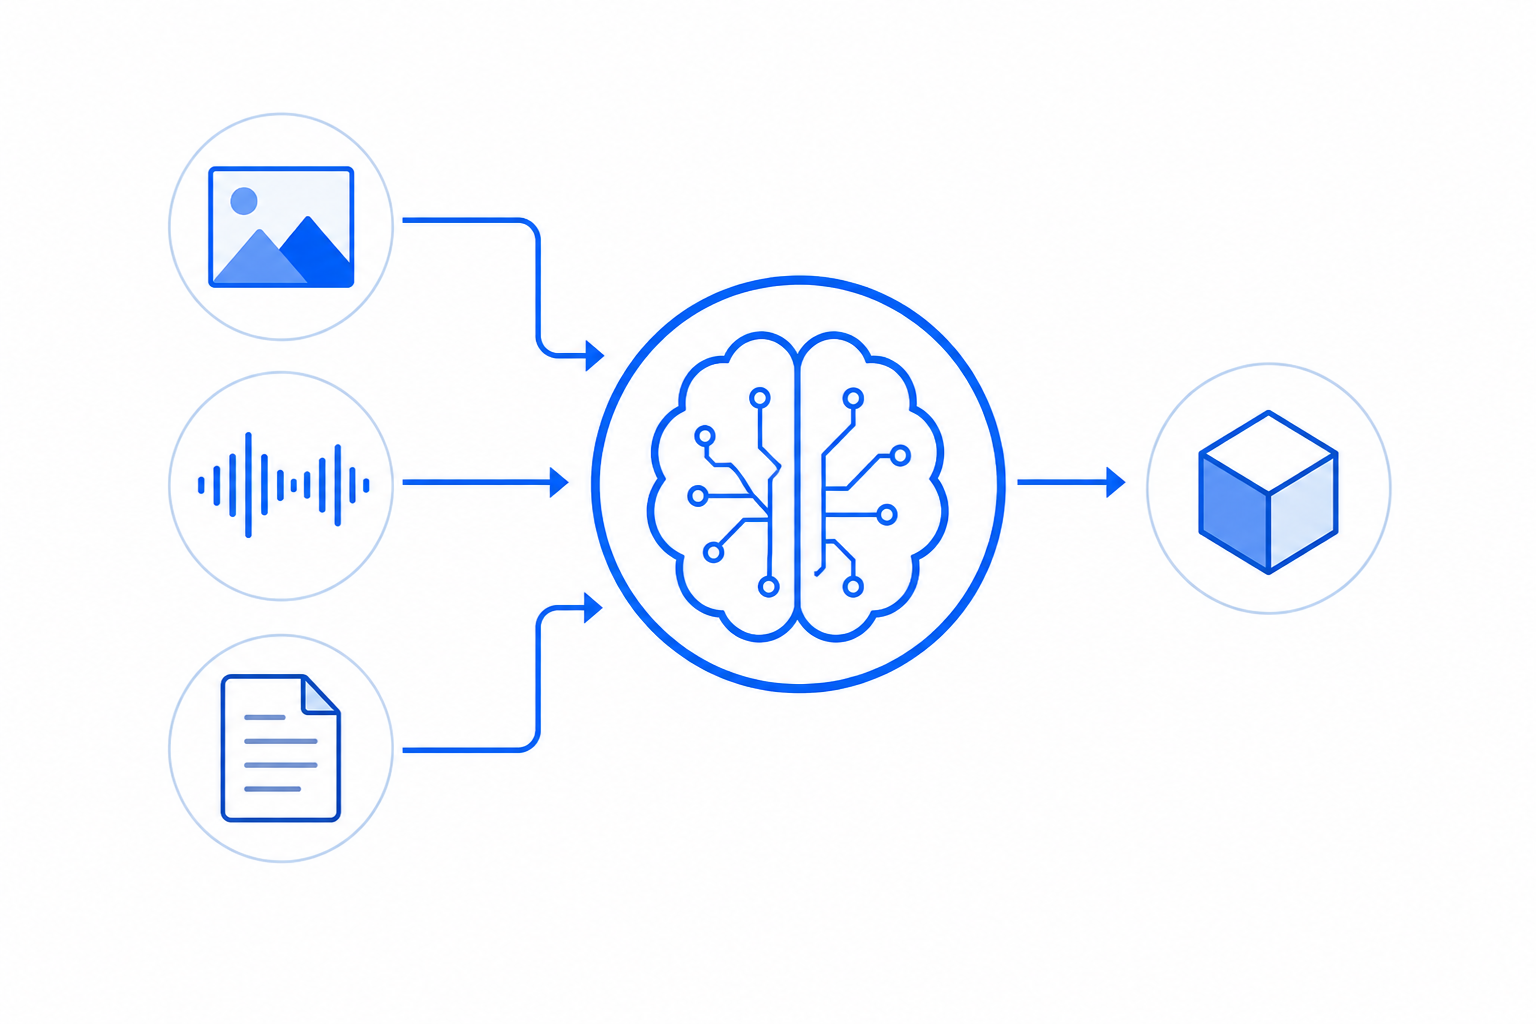
マルチモーダルAIは、テキスト・画像・音声など複数の情報を同時に理解し活用する人工知能です。近年、deep learningやmachine learning技術の進化により、AI applicationsの幅が急速に広がっています。本記事では、その基本概念と仕組みを解説します。
マルチモーダルAIとは何か?基本概念と仕組み
マルチモーダルAIとは
マルチモーダルAIは、テキスト・画像・音声・動画など複数の異なる種類のデータ(モーダル)を同時に理解し、総合的に処理できる人工知能です。従来のAIは文章や画像など単一のデータタイプに特化していましたが、マルチモーダルAIはこれら複数の情報源を組み合わせて解析することで、より人間に近い認識や判断を実現します。例えば、人間は会話の内容だけでなく表情や声のトーンなども同時に受け取って理解します。マルチモーダルAIも同様に、現実世界の複雑な状況を多角的に把握し、柔軟な対応が可能です。このような特徴から、マルチモーダルAIは次世代の人工知能として注目されています。
なぜ今マルチモーダルAIが注目されているのか
現代社会ではSNSやIoTデバイスの普及により、テキスト、画像、音声、動画など多様なデータが日々生成されています。こうした多様なデータを一元的に解析し、より精度の高い判断や予測を行うために、マルチモーダルAIの技術が重要になっています。近年の深層学習(deep learning)や機械学習(machine learning)の進化により、異なるモーダルの情報を統合して処理することが現実的になりました。これによりAIは従来よりも複雑なタスクや状況に対応でき、医療やセキュリティ、エンターテインメントなど幅広い分野で応用が進んでいます。今後もマルチモーダルAIの発展によって、人工知能の可能性はさらに広がると期待されています。
マルチモーダルAIの活用分野
マルチモーダルAIは、医療診断、監視カメラの異常検知、音声アシスタント、画像とテキストの自動生成など多様な分野で活用されています。例えば医療分野では画像診断とカルテ情報を組み合わせて診断精度を高めたり、eコマースでは商品画像とレビュー文を同時に解析してレコメンド精度を向上させたりしています。教育分野では映像授業とテキスト教材を組み合わせた個別最適化学習、セキュリティ分野では映像と音声を同時に解析して異常を検知するシステムも実用化されています。今後もマルチモーダルAIの応用範囲は拡大し続けるでしょう。
| 活用分野 | 具体例 |
|---|---|
| 医療 | 画像+テキストで診断支援 |
| セキュリティ | 映像+音声で異常検知 |
| AIアシスタント | 音声+画像で状況理解 |
1. マルチモーダルAIの概要と重要性
マルチモーダルAIとは
マルチモーダルAIは、テキスト・画像・音声・動画など複数の異なる種類のデータ(モーダル)を同時に理解し、総合的に処理できる人工知能です。従来のAIは単一のデータタイプに特化していましたが、マルチモーダルAIはこれら複数の情報源を組み合わせて解析することで、より人間に近い認識や判断を実現します。
例えば、人間が会話の内容だけでなく表情や声のトーンも同時に受け取って理解するように、マルチモーダルAIも現実世界の複雑な状況を多角的に把握し、柔軟な対応が可能です。この特徴により、マルチモーダルAIは次世代の人工知能として注目されています。
なぜ今マルチモーダルAIが注目されているのか
現代社会ではSNSやIoTデバイスの普及により、テキスト、画像、音声、動画など多様なデータが日々生成されています。こうした多様なデータを一元的に解析し、より精度の高い判断や予測を行うために、マルチモーダルAIの技術が重要になっています。
近年の深層学習(deep learning)や機械学習(machine learning)の進化により、異なるモーダルの情報を統合して処理することが現実的になりました。これによりAIは従来よりも複雑なタスクや状況に対応でき、幅広い分野で応用が進んでいます。
マルチモーダルAIの活用分野
マルチモーダルAIは、医療診断、監視カメラの異常検知、音声アシスタント、画像とテキストの自動生成など多様な分野で活用されています。例えば医療分野では画像診断とカルテ情報を組み合わせて診断精度を高めたり、eコマースでは商品画像とレビュー文を同時に解析してレコメンド精度を向上させたりしています。
| 活用分野 | 具体例 |
|---|---|
| 医療 | 画像+テキストで診断支援 |
| セキュリティ | 映像+音声で異常検知 |
| AIアシスタント | 音声+画像で状況理解 |
今後もマルチモーダルAIの応用範囲は拡大し続け、さまざまな業界で新たな価値を生み出すと期待されています。
2. マルチモーダルAIの歴史と発展背景
従来のAIとの違い
従来のAIは、テキスト、画像、音声など単一のデータタイプごとに個別のモデルを用いて処理していました。このため、例えば画像認識AIは画像のみ、音声認識AIは音声のみを対象としており、異なる情報源を同時に扱うことが困難でした。
一方、マルチモーダルAIは複数のモーダル(データ形式)を同時に解析し、相互の関係性を理解することが可能です。これにより、より人間に近い多角的な判断や認識が実現できる点が大きな違いです。
| AIの種類 | 扱うデータ | 特徴 |
|---|---|---|
| 従来型AI | 単一モーダル | 個別処理・限定的な理解 |
| マルチモーダルAI | 複数モーダル | 統合的な解析・柔軟な応用 |
技術進化の流れ
2000年代初頭までは、AIは主にルールベースや単純な機械学習手法が中心で、モーダルごとの独立した処理が一般的でした。しかし、2010年代に入りディープラーニング技術が急速に発展し、異なるデータタイプを同時に扱うためのニューラルネットワーク構造が登場しました。
特に、画像とテキスト、音声と映像など複数モーダルを統合するための「マルチモーダル融合技術」が進化し、より高精度なAIシステムの開発が可能となりました。これにより、AIの応用範囲が大きく広がっています。
主要な研究・開発事例
代表的な事例として、画像とテキストを組み合わせてキャプションを生成する「Image Captioning」や、音声と映像を同時に解析する「マルチモーダル感情認識」などがあります。近年では、OpenAIのCLIPやGoogleのMultimodal Transformerなど、複数モーダルを統合的に理解するモデルが登場し、注目を集めています。
これらの研究開発により、マルチモーダルAIは検索エンジン、医療診断、ロボティクスなど幅広い分野で実用化が進んでいます。
3. マルチモーダルAIの基本用語と概念
「モーダル」とは何か
マルチモーダルAIにおける「モーダル(modal)」とは、AIが扱う情報の種類や形式を指します。たとえば、テキスト、画像、音声、動画などが代表的なモーダルです。人間が視覚や聴覚など複数の感覚を使って世界を理解するのと同様、AIも複数のモーダルを組み合わせて認識や推論を行います。
| モーダルの例 | 具体的なデータ |
|---|---|
| テキスト | 文章、単語、キーワード |
| 画像 | 写真、イラスト、図表 |
| 音声 | 会話、音楽、環境音 |
| 動画 | 映像+音声の組み合わせ |
入力データの種類(テキスト・画像・音声など)
マルチモーダルAIは、テキスト、画像、音声、動画など複数のデータを同時に入力として利用します。例えば画像の内容を説明するキャプション生成や、音声と映像を組み合わせた感情認識など、従来よりも高度なAIアプリケーションが可能です。また、テキストと画像を組み合わせて商品の説明文を自動生成したり、音声と映像から会議内容を要約するなど、実社会での応用も広がっています。異なる種類のデータを連携させることで、単一モーダルAIでは難しかった複雑なタスクにも対応できるのが特徴です。
- テキスト:ニュース記事、SNS投稿、チャット履歴
- 画像:写真、医療画像、商品画像
- 音声:会話録音、音声コマンド
- 動画:監視カメラ映像、教育動画
融合技術(マルチモーダル融合)
マルチモーダル融合技術は、異なるモーダルから得られる情報を統合し、AIが一貫した判断や推論を行うための手法です。ディープラーニングでは、各モーダルの特徴を抽出し、共通の表現空間で組み合わせることで、相互の関連性を学習します。たとえば画像とテキストを同時に解析することで、画像の内容をより正確に理解したり、音声と映像を組み合わせて話者の感情や意図を推定することが可能です。
# 例:画像とテキストの特徴を統合する疑似コード
image_features = ImageEncoder(image)
text_features = TextEncoder(text)
combined = FusionLayer(image_features, text_features)
output = Classifier(combined)
このような融合によって、AIは複雑な状況や文脈をより深く理解でき、検索や認識、生成など多様な応用が可能となります。
4. マルチモーダルAIの仕組みと動作例
データの統合と処理フロー
マルチモーダルAIは、テキストや画像、音声など複数の種類のデータを同時に扱います。各モーダルごとに専用のエンコーダ(例:画像用CNN、テキスト用Transformer)で特徴量を抽出し、融合層でそれらを統合します。統合された特徴は、分類や生成などのタスクに活用されます。
この仕組みにより、AIは複数の情報源から文脈や意味を総合的に理解できます。たとえば、画像と説明文を同時に解析し、より正確な認識や推論を実現します。
| 処理ステップ | 主な役割 |
|---|---|
| 特徴抽出 | 各モーダルから重要な情報を取り出す |
| 特徴融合 | 異なるモーダルの特徴を統合 |
| 推論・生成 | 統合情報をもとに出力を生成 |
代表的なアルゴリズム・モデル
マルチモーダルAIでよく使われるのは、TransformerベースのモデルやAttention機構を活用した手法です。代表例として「CLIP」や「ViLT」などがあり、画像とテキストを同時に学習し、共通の特徴空間で扱えます。
これらのモデルは画像とテキストの関連性を高精度で捉えられるため、検索や分類、生成タスクで高い性能を発揮します。下記はCLIPの処理イメージ例です。
# CLIPモデルの簡易フロー
image_features = ImageEncoder(image)
text_features = TextEncoder(text)
similarity = CosineSimilarity(image_features, text_features)
実際の応用例とユースケース
マルチモーダルAIは、さまざまな分野で実用化が進んでいます。画像と説明文を組み合わせた商品検索や、動画と音声を使った自動字幕生成、医療画像と診断レポートの連携解析などが代表例です。
また、SNS投稿と画像を同時に解析して不適切コンテンツを検出するなど、AIアプリケーションの幅が広がっています。異なるモーダルを組み合わせることで、従来のAIよりも多角的で信頼性の高い判断が可能となります。
- マルチモーダル検索(画像+テキスト)
- 自動キャプション生成(画像+自然言語)
- 医療診断支援(画像+診療記録)
- 感情認識(音声+映像)
5. マルチモーダルAIの課題・今後の展望
現状の課題と制約
マルチモーダルAIは多様なデータを統合できる一方、各モーダル間のデータ品質や量の不均衡が課題です。例えば、画像とテキストの両方が揃っていないデータセットでは、十分な学習や正確な推論が難しくなります。また、融合技術の設計が未成熟で、ノイズや冗長な情報が結果に影響することもあります。
| 主な課題 | 具体例 |
|---|---|
| データの不均衡 | 画像は多いが説明文が少ない |
| 融合技術の限界 | 異種データ間の意味的なギャップ |
| 計算コスト | 大規模モデルの学習負荷 |
今後期待される進化
今後は、より高度な融合アルゴリズムや効率的な学習手法の開発が進むと予想されます。たとえば、少ないデータでも高精度な推論が可能な「少数ショット学習」や、複数モーダル間の連携を強化する新しいモデル設計が期待されています。さらに、リアルタイム処理や省エネ型AIの実現も重要な進化ポイントです。自己教師あり学習や転移学習など、データ不足を補う技術の進化も進むでしょう。医療や教育、ロボティクスなど応用範囲の拡大も見込まれ、マルチモーダルAIは今後ますます多様な分野で活用されていくと考えられます。
- モーダル間の連携強化
- データ不足への対応(自己教師あり学習など)
- 応用範囲の拡大(医療・教育・ロボティクスなど)
初心者が学ぶためのステップとリソース
まずは機械学習やディープラーニングの基礎を学び、画像・テキスト・音声など個別モーダルの処理技術を理解しましょう。その後、マルチモーダルAIの入門書やオンライン講座、オープンソースの実装例を活用するのがおすすめです。実際に小規模なプロジェクトで試すことで、理解が深まります。
| 学習ステップ | 主なリソース |
|---|---|
| 基礎理論の習得 | Coursera・UdemyのAI講座 |
| 実装体験 | Kaggle・GitHubのサンプルコード |
| 最新動向の把握 | arXiv論文・AI関連ブログ |
マルチモーダルAIは、テキスト・画像・音声など複数の情報源を統合して処理する人工知能技術です。従来のAIと比べて、より人間に近い理解や判断が可能となり、さまざまな分野で注目されています。今後も技術の進化とともに応用範囲が広がることが期待されています。
- マルチモーダルAIは複数のデータ(モーダル)を統合して処理するAI
- 従来のAIよりも高度な理解や判断が可能
- 医療、教育、エンタメなど幅広い分野で活用が進む
- 融合技術や新しいアルゴリズムの発展が重要な鍵
- 現状はデータ統合やモデル設計に課題もあるが、今後の進化に期待
- 初心者向けの学習リソースも充実しつつある