DXFファイルは、CAD間のデータ交換だけでなく、図形データの解析、Pythonによる自動作図、図面チェック、WebツールからのCADデータ生成などにも利用できます。
特にDXFの構造を理解すると、「CAD画面で見えている線や円が、ファイル内部ではどのようなデータとして保存されているのか」が分かるようになります。
結論からいえば、DXFを理解するうえで重要なのは次の3点です。
- DXFはグループコードと値の組を基本単位としている
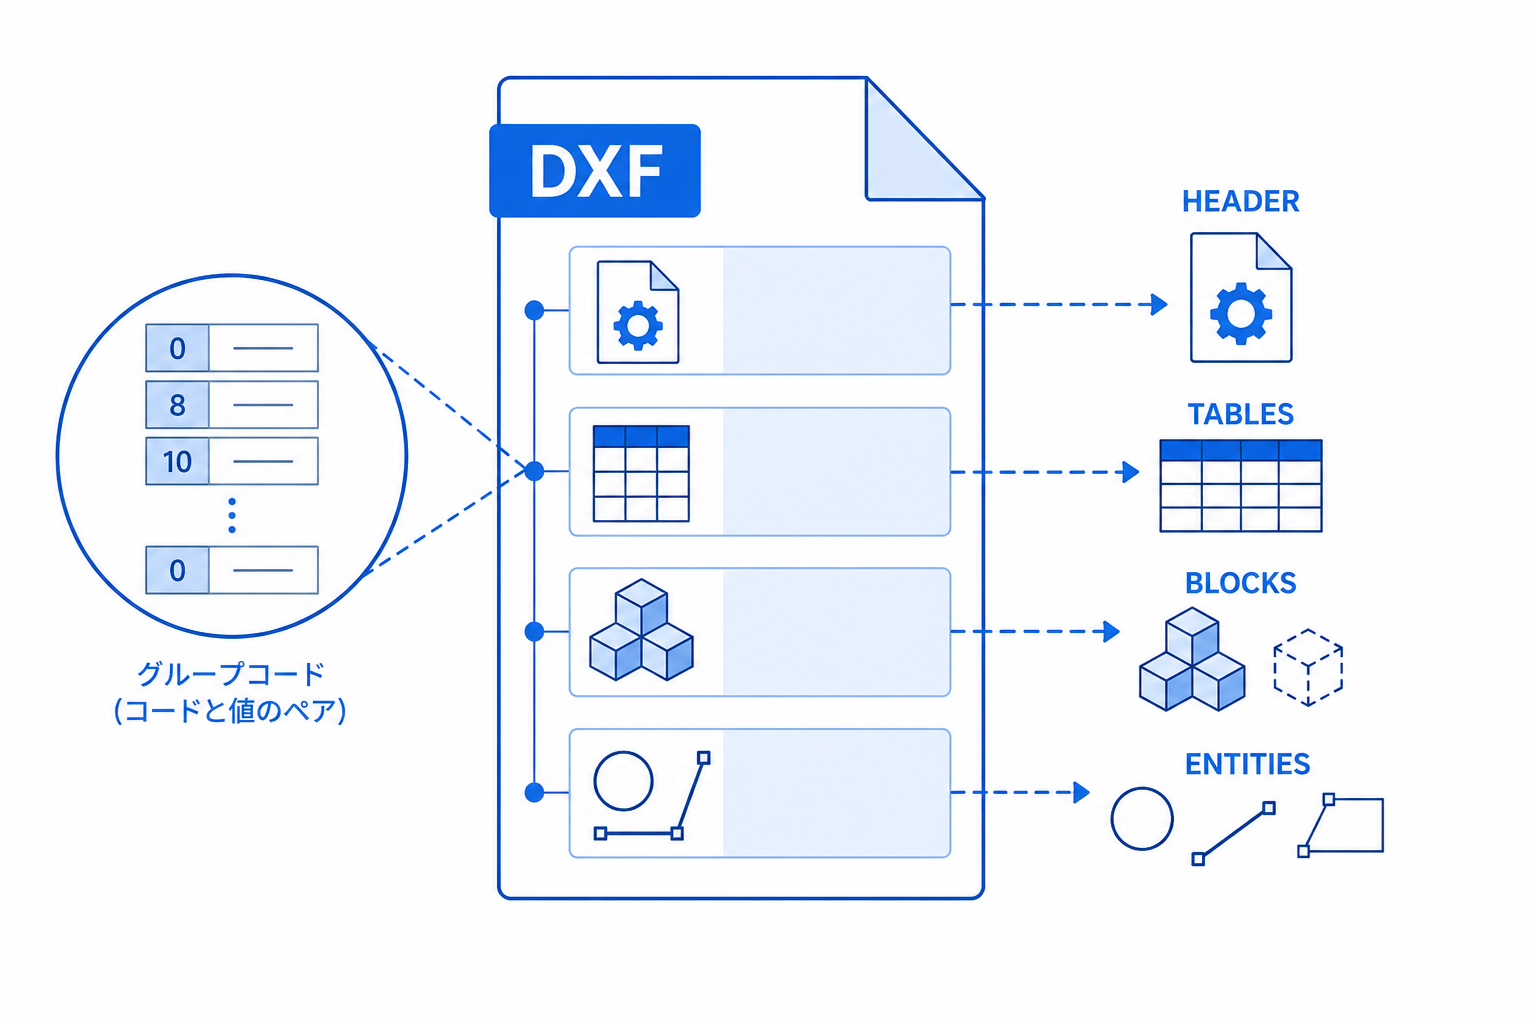
- データはHEADER、TABLES、BLOCKS、ENTITIESなどのセクションに分かれている
- 線分、円、ポリラインなどの図形は、ENTITIESセクション内でそれぞれ固有のグループコードによって表現される
この構造を理解すれば、DXFを単なる「CADの保存形式」としてではなく、機械的に処理できる構造化データとして扱えるようになります。
DXFファイルはどのような構造なのか
AutodeskのDXFリファレンスでは、DXFファイルは基本的にグループコードと、それに対応する値のペアで構成されると説明されています。
ASCII形式の場合、グループコードと値はそれぞれ別の行に記録されます。たとえば、
0
LINE
8
0
10
25.0
20
10.0
のような形です。
ここで重要なのは、「10」という数字そのものが座標値なのではないということです。
10はグループコードであり、その次の25.0が実際の値です。グループコードによって、後続する値が何を意味するのかが決まります。DXFをプログラムで読む場合も、この「コード→値」という対応を基本単位として扱います。
なお、DXFにはASCII形式だけでなくバイナリ形式も存在します。Autodeskの資料では、バイナリDXFも同じグループコードと値の考え方を持ちながら、データをバイナリ表現で格納するとされています。人間が構造を学習したり、簡単な解析ツールを作ったりする場合は、まずASCII DXFを対象にすると理解しやすいでしょう。
DXFを構成する主要セクション
DXFファイルは一枚の巨大な図形リストではありません。用途ごとに複数のセクションへ分かれています。
Autodeskが示す主要な構成は次の通りです。
| セクション | 主な役割 |
|---|---|
| HEADER | 図面全体に関係する設定やシステム変数 |
| CLASSES | アプリケーション定義クラスの情報 |
| TABLES | 画層、線種、文字スタイルなどのシンボルテーブル |
| BLOCKS | ブロック定義 |
| ENTITIES | 線、円、ポリラインなどの図形 |
| OBJECTS | 辞書などの非図形オブジェクト |
| THUMBNAILIMAGE | 図面のプレビュー画像。省略可能 |
セクションは一般に、
0
SECTION
2
ENTITIES

...

0
ENDSEC
のような形で表現されます。
グループコード0とSECTIONによってセクション開始を示し、続くコード2の値によってセクション名を示します。そして0とENDSECでそのセクションが終了します。
この構造を理解しておくと、DXFを解析するときに「現在どのセクションを読んでいるのか」という状態を持たせる設計ができます。
HEADERセクション
HEADERには図面全体に関係する設定値が格納されます。
Autodeskの仕様では、HEADER内の変数名にはグループコード9が使われ、その後に変数の値を表すグループが続きます。
概念的には、
0
SECTION
2
HEADER
9
$変数名
...
0
ENDSEC
という構造です。
DXFを生成するプログラムを作る場合、図形だけではなく、ファイルバージョンや図面設定などもHEADERとの関係で考える必要があります。
TABLESセクション
TABLESには、画層や線種など、複数の図形から共通して参照される情報が保存されます。
代表的なテーブルとしてAutodeskは、
- LAYER
- LTYPE
- STYLE
- DIMSTYLE
- UCS
- VIEW
- VPORT
- BLOCK_RECORD
などを挙げています。
たとえば、ENTITIES内の線分が特定の画層を参照している場合、画層そのものの定義はTABLES側に存在します。
したがってDXFを本格的に解析する場合、
図形
↓
画層名
↓
LAYERテーブル
↓
画層属性
という参照関係を考える必要があります。
単純な「線分の座標を抜き出す」処理と、「図面全体を正確に再構築する」処理では、必要な解析範囲が大きく異なる理由の一つです。
BLOCKSとENTITIESの違い
BLOCKSセクションにはブロックの定義が格納されます。
一方、ENTITIESには図面上のグラフィカルなオブジェクトが格納され、ブロック参照もここに含まれます。
そのためブロックを含む図面では、
BLOCKS
  ↓
ブロックそのものの定義

ENTITIES
  ↓
ブロックをどこへ配置するか
という関係を意識する必要があります。
DXFを自動処理するときにENTITIESだけ読んでいると、ブロック内部の形状を展開できない場合があります。
グループコードとは何か
DXFの核心となるのがグループコードです。
グループコードは「次に続く値が何を意味するか」を識別するための番号です。ただし、すべてのコードがあらゆる場所で同じ意味を持つわけではなく、文脈や図形タイプによって意味が決まるものもあります。
代表例を簡略化すると次のようになります。
| コード | 主な意味の例 |
|---|---|
| 0 | 図形タイプやレコードタイプ |
| 5 | ハンドル |
| 8 | 画層名 |
| 9 | HEADER内の変数名 |
| 10 | 主要点のX座標 |
| 20 | 主要点のY座標 |
| 30 | 主要点のZ座標 |
| 11 | 別の点のX座標 |
| 21 | 別の点のY座標 |
| 31 | 別の点のZ座標 |
| 40番台 | 各種倍精度浮動小数点値 |
| 90番台 | 32bit整数値 |
Autodeskの数値順リファレンスでも、コード0は図形タイプ、8は画層名、10は主要点のX値などとして定義されています。
ただし、「コード10だから必ず線分の始点」という理解は正確ではありません。
コード10はさまざまな図形で「主要な点」のX成分として使われます。LINEでは始点ですが、別の図形では中心点や頂点などになる可能性があります。
したがって、
図形タイプ
+
グループコード
の組み合わせで意味を判定する設計が重要です。
LINE図形を例に読む
LINEはDXF構造を理解するのに適した単純な図形です。
AutodeskのLINE仕様では、始点と終点に次のコードが使われます。
| 内容 | X | Y | Z |
|---|---|---|---|
| 始点 | 10 | 20 | 30 |
| 終点 | 11 | 21 | 31 |
理解用に簡略化すると、次のように読めます。
0
LINE
8
0
10
0.0
20
0.0
30
0.0
11
100.0
21
50.0
31
0.0
これは概念的には、
図形タイプ = LINE
画層 = 0
始点 = (0, 0, 0)
終点 = (100, 50, 0)
と構造化できます。
実際のDXFでは、ハンドル、所有者、サブクラスマーカーなど追加の情報が含まれる場合があります。この例はDXFの読み方を説明するために必要な部分だけを抜き出したものです。
LWPOLYLINEでは同じコードが繰り返される
ポリラインになると構造は少し複雑になります。
AutodeskのLWPOLYLINE仕様では、
90:頂点数70:各種フラグ10:頂点X座標20:頂点Y座標42:ふくらみ
などが使われます。
コード10と20は頂点ごとに繰り返して現れます。
つまりDXFパーサーでは、
コード10を1回だけ取得する
という実装では不十分です。
同一コードが何回現れたか、どの図形内で現れたか、順序にどのような意味があるかまで扱えるデータ構造が必要になります。
PythonでDXFを解析するなら二段階に分ける
DXF処理を自作する場合は、最初からLINEやCIRCLEを直接読み取るより、
テキスト
↓
グループコード・値のペア
↓
セクション
↓
図形
↓
正規化した幾何データ
のように段階を分けると扱いやすくなります。
最初の「コードと値を分離する」処理だけなら、概念的には次のように書けます。
def parse_dxf_pairs(text: str):
    lines = text.splitlines()

    if len(lines) % 2 != 0:
        raise ValueError("DXFのコードと値の対応が崩れています")

    pairs = []

    for i in range(0, len(lines), 2):
        code = int(lines[i].strip())
        value = lines[i + 1].strip()
        pairs.append((code, value))

    return pairs
ただし、これは学習用の最小例です。
実用的なDXFパーサーではさらに、
- 値の型変換
- セクション管理
- 図形タイプ別処理
- 画層やブロックへの参照
- ハンドル
- 座標系
- 未対応図形
- DXFバージョン差
- 文字コード
- バイナリDXF
などを扱う必要があります。
生のDXFをそのままアプリケーション全体で使うのではなく、一度自分の内部データモデルへ正規化した方が再利用しやすくなります。
DXF処理で起こりやすい失敗
グループコードだけで意味を決める
同じグループコードでも、図形タイプや位置によって意味が変わります。
10という番号だけを見て処理するのではなく、
現在のセクション
現在の図形タイプ
グループコード
を組み合わせて解釈する必要があります。
WCSとOCSを混同する
LINEの始点・終点はAutodeskの仕様上WCSで表現されます。一方、LWPOLYLINEの頂点座標はOCSとして定義されています。
単純な2D図面では違いが表面化しにくくても、押し出し方向や3次元データを扱うと問題になります。
ENTITIESだけで図面全体を理解しようとする
画層はTABLES、ブロック定義はBLOCKS、非図形オブジェクトはOBJECTSに存在します。
図形座標だけ必要なのか、図面を完全に再現したいのかによって必要な解析範囲を決めるべきです。
ASCII DXFだけを前提にする
テキストとして読めるDXFだけでなくバイナリDXFも存在します。
自動処理システムでは「入力はASCII DXFだけ」と仕様で制限するのか、バイナリにも対応するのかを明示する必要があります。
DXFをデータ化すると何ができるか
DXFの生データを解析し、たとえばLINEを、
{
  "type": "LINE",
  "layer": "0",
  "start": {
    "x": 0.0,
    "y": 0.0,
    "z": 0.0
  },
  "end": {
    "x": 100.0,
    "y": 50.0,
    "z": 0.0
  }
}
のような中間データへ変換すれば、CAD以外の処理と接続しやすくなります。
たとえば、
- 図形数の集計
- 画層別の検査
- 寸法や形状の抽出
- 禁止画層や命名規則のチェック
- JSONからDXFを生成
- Pythonによる自動作図
- Webフォームから図面生成
- CADソフトに依存しない中間データ保存
などへ発展させられます。
重要なのは、DXFそのものを業務ロジックの正本にしないことです。
設計データ
↓
内部モデル
↓
DXF
という構造にしておけば、将来別のCAD形式やWeb表示へ展開するときにも設計ロジックを再利用できます。
DXF自動化では「解析」と「生成」を分離する
実務用のDXFシステムを作るなら、次のような責務分離が有効です。
DXF Reader
↓
Normalized Geometry
↓
Design / Validation Logic
↓
DXF Writer
ReaderはDXFを理解する役割、Geometryは図形をCAD非依存で保持する役割、Validation Logicは設計ルールを判断する役割、Writerは再びDXFへ変換する役割です。
こうしておけば、「DXFを読むコード」と「設計判断をするコード」が混ざりません。
これは将来的にCAD自動化を拡張するうえで非常に重要な設計になります。
まとめ
DXFファイルを理解する第一歩は、CADソフトの操作ではなく内部構造を知ることです。
基本構造は、
グループコード
+
値
↓
レコード
↓
セクション
↓
DXFファイル
と整理できます。
さらに、
- HEADER:図面全体の情報
- TABLES:画層や線種などの共通定義
- BLOCKS:ブロック定義
- ENTITIES:線、円、ポリラインなどの図形
- OBJECTS:非図形オブジェクト
という責務を理解すれば、DXFファイルを構造化データとして捉えられるようになります。
特にPythonやWebツールからCADデータを生成したい場合、DXFは「ファイル形式」ではなく、設計データをCADへ渡すための出力形式の一つとして扱うと、再利用性の高いシステムを設計できます。
参考情報
- Autodesk「About the General DXF File Structure」 Autodesk DXFの基本構造
- Autodesk「About Group Codes in DXF Files」 Autodesk DXFグループコード解説
- Autodesk「LINE (DXF)」 Autodesk LINE仕様
- Autodesk「LWPOLYLINE (DXF)」 Autodesk LWPOLYLINE仕様