システム間でeventやrecordを長期間受け渡すと、送信側と受信側を同じ日に更新できないことがあります。新しいfieldを追加しただけでも、古いconsumerが読めなくなれば連携は停止します。
Apache Avroは、JSONで定義したschemaとbinary dataを組み合わせるserialization方式です。dataを書いたときのwriter schemaと、読む側が期待するreader schemaを照合することで、一定範囲のschema変更を吸収できます。この記事では、型付きeventの構造、互換性規則、Python実装、再処理とversion管理を整理します。
Avroで解決すること
JSON単体では、1が32bit整数か64bit整数か、日時文字列がどの精度か、field追加をどう扱うかは別の契約が必要です。Avroではrecord、field、type、defaultをschemaに定義します。
Apache Avro 1.12.0仕様が定めるprimitive typeは、null、boolean、int、long、float、double、bytes、stringです。record、enum、array、map、union、fixedも組み合わせられます。
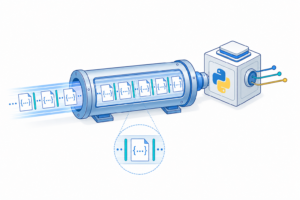
Avro Object Container Fileでは、file headerにwriter schemaが保存され、recordはbinary encodingされたblockとして格納されます。message brokerで1 recordずつ送る場合は、schemaそのものではなくschema IDやfingerprintをpayloadへ関連付ける運用が必要です。
最小の測定event schema
圧力測定eventのversion 1を次のschemaにします。
{
  "type": "record",
  "name": "Measurement",
  "namespace": "com.example.engineering",
  "fields": [
    {"name": "measurement_id", "type": "string"},
    {
      "name": "measured_at",
      "type": {"type": "long", "logicalType": "timestamp-micros"}
    },
    {"name": "pressure_pa", "type": "long"},
    {"name": "valid", "type": "boolean"},
    {"name": "note", "type": ["null", "string"], "default": null}
  ]
}schema全体がrecord、fieldsがfield定義のarrayです。各fieldはnameとtypeを持ちます。noteはnullまたはstringを許すunionです。
最小の入力recordは次の形です。
{
  "measurement_id": "m-000184",
  "measured_at": "2026-10-09T01:30:00Z",
  "pressure_pa": 14000000,
  "valid": true,
  "note": null
}
JSONは入力例であり、Avro binary内の日時は文字列ではありません。timestamp-microsはUnix epochからのmicrosecond数を持つlongへ意味を付けるlogical typeです。入力境界でtimezone付き日時をUTCへ正規化します。
writer schemaとreader schemaを分ける
writer schemaはdataをserializeしたときのschema、reader schemaは現在のapplicationが期待するschemaです。両者を同じものとして固定すると、過去dataを読むたびに旧applicationが必要になります。
version 2では校正記録への参照を追加します。
{
  "type": "record",
  "name": "Measurement",
  "namespace": "com.example.engineering",
  "fields": [
    {"name": "measurement_id", "type": "string"},
    {
      "name": "measured_at",
      "type": {"type": "long", "logicalType": "timestamp-micros"}
    },
    {"name": "pressure_pa", "type": "long"},
    {"name": "valid", "type": "boolean"},
    {"name": "note", "type": ["null", "string"], "default": null},
    {
      "name": "calibration_id",
      "type": ["null", "string"],
      "default": null
    }
  ]
}旧dataにはcalibration_idがありませんが、reader schemaにdefaultがあるためnullとして補えます。defaultは「書き込み時にfieldを省略してよい」という意味ではなく、schema解決時にwriter側へ存在しないfieldを補う値です。
schema解決の基本規則
Avro仕様ではrecord fieldを宣言順ではなくnameで対応付けます。
| 変更 | readerの動作 | 注意点 |
|---|---|---|
| default付きfieldを追加 | defaultで補完 | defaultの意味を契約化する |
| writerだけにあるfield | readerは無視 | dataを再保存すると失われ得る |
| defaultなしfieldをreaderへ追加 | 読取error | 既存dataと非互換 |
| field順を変更 | nameで照合 | record名とfield名を維持する |
| intからlongへ拡張 | promotion可能 | 逆方向は保証されない |
| field名を変更 | 原則別field | 必要ならreader側aliasを検討 |
["null", "string"]のようなunionでは、どのbranchへ値を対応させるかもschemaの一部です。defaultの型がunion内の型と一致することを確認し、optionalのつもりならNULLとfield未指定の意味も分けます。
Pythonで旧schemaを書き新schemaで読む
次の例はversion 1でfileを書き、calibration_idを追加したversion 2で読みます。Python 3では公式のavro packageを使います。
import json
from datetime import datetime, timezone

import avro.schema
from avro.datafile import DataFileReader, DataFileWriter
from avro.io import DatumReader, DatumWriter


V1 = {
    "type": "record",
    "name": "Measurement",
    "namespace": "com.example.engineering",
    "fields": [
        {"name": "measurement_id", "type": "string"},
        {
            "name": "measured_at",
            "type": {"type": "long", "logicalType": "timestamp-micros"},
        },
        {"name": "pressure_pa", "type": "long"},
        {"name": "valid", "type": "boolean"},
        {"name": "note", "type": ["null", "string"], "default": None},
    ],
}

V2 = {
    **V1,
    "fields": V1["fields"]
    + [
        {
            "name": "calibration_id",
            "type": ["null", "string"],
            "default": None,
        }
    ],
}

writer_schema = avro.schema.parse(json.dumps(V1))
reader_schema = avro.schema.parse(json.dumps(V2))

with open("measurements.avro", "wb") as stream:
    with DataFileWriter(stream, DatumWriter(), writer_schema) as writer:
        writer.append(
            {
                "measurement_id": "m-000184",
                "measured_at": datetime(
                    2026, 10, 9, 1, 30, tzinfo=timezone.utc
                ),
                "pressure_pa": 14_000_000,
                "valid": True,
                "note": None,
            }
        )

with open("measurements.avro", "rb") as stream:
    datum_reader = DatumReader(readers_schema=reader_schema)
    with DataFileReader(stream, datum_reader) as reader:
        records = list(reader)

assert records[0]["calibration_id"] is None
Apache AvroのPython入門資料でも、DataFileWriter、DatumWriter、DataFileReader、DatumReaderを使う基本形が示されています。fileはbinary modeで開きます。
正常系と異常系をテストする
schema fileがJSONとしてparseできるだけでは、互換性を確認したことになりません。最低限、次を自動テストします。
- version 1で書いたrecordをversion 2で読める
- 追加fieldへ期待したdefaultが入る
- 必須field欠落、型違い、未知のenum symbolを拒否する
falseと0、NULLと空文字を混同しない- timezoneなし日時を入力境界で拒否する
measurement_id重複をDBまたは受信処理で検出する- 未対応schema versionを隔離する
Avroの型検証は、圧力が業務上の許容範囲か、IDが一意か、単位がPaかまでは判断しません。構造validationと業務validationを分けます。
logical typeと単位の落とし穴
logical typeはprimitive typeへ意味を追加します。日時ならtimestamp-micros、十進数ならdecimalを利用できます。ただし、利用する言語の実装がそのlogical typeをどのobjectへ変換するかを確認します。
Decimalではprecisionとscaleも互換性判定へ影響します。floatへ変換してから保存せず、十進数として扱います。圧力のような単位はAvro標準のlogical typeではないため、pressure_paのようなfield名、schema property、またはdata contractで固定します。
schemaをIDと履歴で管理する
schema本文を毎messageへ添付するとpayloadが大きくなります。運用では次を管理します。
- schemaの不変IDまたはfingerprint
- schema本文と登録日時
- backward・forwardの互換性方針
- producerとconsumerが利用中のversion
- 廃止予定fieldと移行期限
- schema変更のtest結果
Object Container Fileにはwriter schemaが入ります。一方、single-object encodingはmarker、schema fingerprint、binary dataで構成されます。受信側がfingerprintから正しいwriter schemaを解決できる仕組みが必要です。
schema IDをpayloadの業務IDとして使ってはいけません。measurement_idはrecordの同一性、schema IDは構造の同一性を表します。
冪等性と再処理
Avroはserialization方式であり、重複排除を自動では行いません。messageの再送に備えて不変のevent IDを持たせ、受信側の一意制約で処理済みを判定します。
過去recordを新schemaへ変換するときは、元dataを上書きせず、writer schema ID、変換program version、出力schema IDを記録します。同じ入力と変換versionから同じ出力へ収束するようにし、途中失敗後もbatch IDから再開できる設計にします。
セキュリティと公開情報の分離
Avro binaryは暗号化ではありません。API key、token、passwordをrecordやschema metadataへ入れず、転送路とstorage側で暗号化・アクセス制御します。
schema自体にも内部system名、顧客名、非公開URLを埋め込まないようにします。信頼できないpayloadではmessage size、array要素数、string長、nested depthを制限し、解釈前に利用可能なschema IDか確認します。
CAD・BOM・APIへ再利用する
CAD属性更新、BOM revision、計算完了、測定結果を共通event envelopeで表し、業務ごとの差をrecord schemaへ閉じ込められます。大きなCAD file自体は埋め込まず、file ID、revision、content hashを渡して認可済みstorageから取得します。
Avro schemaからDB、API、CSVへ変換するときは、longの範囲、NULL、timestamp、Decimal、単位をmapping表として残します。形式を変えても意味が変わらないことが、再利用可能な設計dataの条件です。
まとめ
Apache Avroの中心は、binary化そのものではなく、writer schemaとreader schemaを使った型付きdata契約です。
- recordのfield名、型、defaultをschemaへ明記する
- 追加fieldには既存dataを読めるdefaultを設計する
- defaultと書込時の省略可能性を混同しない
- readerがwriter schemaを解決できるようIDやfingerprintを管理する
- logical type、NULL、単位、IDの意味を別途検証する
- 新旧schemaの組み合わせを自動テストする
- event IDによる重複排除と、変換履歴による再処理を設計する
- secretと機密metadataをdata contractから分離する
この仕組みをAPI、message broker、file、CAD、BOMへ共通化すれば、producerとconsumerを同時更新できない環境でも、過去dataを保持しながらschemaを段階的に変更できます。