n8nでは、多くの処理をEdit Fields、Filter、Aggregateなどの標準nodeとExpressionで組み立てられます。それでも、複雑な入れ子構造の組み替え、独自の計算、複数itemsをまたぐ判定など、画面上の設定だけでは意図を表しにくい場面があります。
そのための選択肢がCode nodeです。
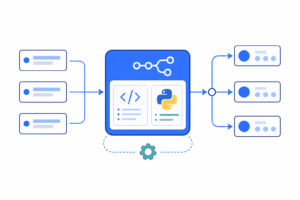
前のnodeからitemsを受け取る
→ JavaScriptまたはPythonで必要な処理を行う
→ n8nのitems形式で返す
→ 次のnodeへ渡す
Code nodeは便利ですが、すべての変換をコードへ置き換えるnodeではありません。この記事では、入出力の約束、実行モード、JavaScriptとPythonの違いを理解し、「標準nodeでは表現しにくいときだけ使う」ための基準を整理します。
今日の到達点
- Code nodeが必要な場面と不要な場面を区別できる
- 2つの実行モードとitemsの扱いを説明できる
- JavaScriptとPythonで、入力itemsを変換して返せる
- item linkingを壊すと後続のデータ参照へ影響することを理解できる
- n8n Cloudとself-hostedにおける外部libraryの制約を把握できる
Code nodeは標準nodeの代替ではなく拡張手段
Code nodeはWorkflowの途中で任意のJavaScriptまたはPythonを実行するnodeです。以前のFunction nodeとFunction Item nodeは、n8n 0.198.0以降、Code nodeへ統合されています。
標準nodeで目的に一致する処理がある
→ 標準nodeを使う

1つのparameterへ短い動的値を入れたい
→ Expressionを使う

複雑な独自変換やアルゴリズムが必要
→ Code nodeを検討する
たとえば、field追加はEdit Fields、絞り込みはFilter、並べ替えはSort、配列化はAggregateで表現できます。これらをCode nodeへ集約するとコード量は減ることがありますが、途中のINPUT/OUTPUTが見えにくくなり、コードを読めない人が修正しづらくなります。
一方、深く入れ子になったJSONを複数の規則で正規化する、複数itemsを照合して独自の結果を作る、既存nodeにない計算を行う、といった処理ではCode nodeが役立ちます。
2つの実行モード
Code nodeには、コードを実行する単位が異なる2つのモードがあります。
Run Once for All Items
既定のモードです。入力itemsの件数にかかわらず、コードを1回実行します。JavaScriptでは$input.all()、native Pythonでは_itemsで入力全体を扱えます。
3 input items
→ コードを1回実行
→ 0件、3件、1件など任意のitemsを返す
複数itemsをまとめて比較する、並べ替える、グループ化する、件数を変える処理に向いています。
Run Once for Each Item
入力itemごとにコードを実行します。1件の入力から1件の出力を作る独立した変換に向いています。native Pythonでは現在のitemを_itemで参照します。
3 input items
→ コードを3回実行
→ 各itemを個別に変換
ただし、n8nの多くの標準nodeはもともと複数itemsを自動処理します。「1件ずつ処理したい」という理由だけでCode nodeを追加する必要はありません。
Code nodeの入出力はitemsで考える
n8nでは、node間のデータはitemsの配列として渡されます。各itemでは、通常jsonがobjectを持ちます。
[
  {
    "json": {
      "name": "Pump A",
      "pressure_mpa": 10
    }
  },
  {
    "json": {
      "name": "Valve B",
      "pressure_mpa": 14
    }
  }
]
Code nodeの出力も、この構造へ合わせます。jsonへ配列や文字列を直接入れるのではなく、objectを入れます。
return [
  {
    json: {
      status: 'ready',
    },
  },
];returnがない、undefinedを返す、jsonがobjectではない、といった場合は期待するitems形式にならずエラーになります。
JavaScriptで小さな変換を作る
実習では、Run Once for All Itemsで圧力の単位をMPaからkPaへ換算します。入力itemと出力itemを1対1で対応させる例です。
const items = $input.all();

return items.map((item, index) => ({
  json: {
    ...item.json,
    pressure_kpa: item.json.pressure_mpa * 1000,
  },
  pairedItem: { item: index },
}));
入力が次の3 itemsなら、出力も3 itemsです。
[
  { "json": { "name": "Pump A", "pressure_mpa": 10 } },
  { "json": { "name": "Valve B", "pressure_mpa": 14 } },
  { "json": { "name": "Cylinder C", "pressure_mpa": 7 } }
]
1件目の出力は次の形になります。
{
  "name": "Pump A",
  "pressure_mpa": 10,
  "pressure_kpa": 10000
}
この変換自体はEdit FieldsとExpressionでも実現できます。つまり、Code nodeの書き方を学ぶには適していますが、実務でこの処理だけを行うなら、画面上で式と型を確認できるEdit Fieldsの方が保守しやすい可能性があります。
Pythonで同じ入出力を作る
n8n 2では、Code nodeのPythonはtask runner上で動くnative Pythonが現在の方式です。以前のPyodide方式はlegacyで、n8n 2ではサポートされません。
Run Once for All Itemsで同じ変換を行う例です。
result = []

for index, item in enumerate(_items):
    data = dict(item["json"])
    data["pressure_kpa"] = data["pressure_mpa"] * 1000
    result.append({
        "json": data,
        "pairedItem": {"item": index},
    })

return result
native Pythonでは、JavaScriptの$input.all()に相当する入力が_items、itemごとのモードでは_itemです。また、item.json.nameのようなdot記法ではなく、item["json"]["name"]のようなbracket記法を使います。
重要なのは、n8nのExpressionsはJavaScript系の記法であり、Pythonではないことです。Code nodeでPythonを選べても、ほかのnodeのExpression欄へPythonを書けるわけではありません。
JavaScriptとPythonの利用範囲
言語は好みだけでなく、実行環境と必要なlibraryで選びます。
| 項目 | JavaScript | native Python |
|---|---|---|
| All Itemsの入力 | $input.all() | _items |
| Each Itemの入力 | $input.itemなど | _item |
| n8nのbuilt-in methods | 利用可能 | _items/_item以外は非対応 |
| objectの参照 | dot/bracket | bracketのみ |
| Cloudでの任意library import | 不可 | 標準・外部とも不可 |
| self-hostedでの追加library | installと許可設定が必要 | runner imageへの追加とallowlistが必要 |
JavaScriptではPromiseを使えるため、非同期処理も記述できます。ただし、Code nodeはfilesystemへ直接アクセスできず、HTTP requestも担当しません。file操作はRead/Write Files from Diskなどのnode、API通信と認証はHTTP Request nodeへ任せます。
また、Code nodeはn8nのCredentialsへアクセスできない設計です。secretをCodeへ直書きしたり、内部のcredential取得を試みたりせず、認証対応nodeを使います。
self-hostedで外部moduleやPython packageを使う場合も、コードへimportやrequireを書くだけでは利用できません。task runnerを含む実行環境への導入と、利用を許可する設定が必要です。Cloudとself-hosted、n8nバージョンによって利用範囲が異なるため、環境の公式ドキュメントを確認してください。
item linkingを壊さない
n8nは、ある出力itemがどの入力itemから作られたかを追跡します。これがitem linkingです。後続nodeで別nodeのデータを参照するとき、n8nはこの対応関係を使って適切なitemを選びます。
入力item 0 → 出力item 0
入力item 1 → 出力item 1
入力item 2 → 出力item 2
Code nodeで新しいitem objectを作る場合、例のpairedItemは出力がどの入力indexに対応するかを明示します。
pairedItem: { item: index }とくに次の処理では注意が必要です。
- 複数itemsを1 itemへまとめる
- 1 itemから複数itemsを作る
- 一部itemsを除外する
- 順序を入れ替える
- 入力とは別のobjectを新規作成する
入力と出力の件数や順序が変わる場合は、どの入力から結果が作られたかを決め、item linkingを設定します。単にJSONの形が正しいだけでは、後続のExpressionによる参照が期待どおりになるとは限りません。
標準node・Expression・Code nodeの選び方
選択は「書けるか」ではなく、「意図と途中結果を最も確認しやすいか」で判断します。
| やりたいこと | 第一候補 |
|---|---|
| fieldを追加・rename・削除する | Edit Fields |
| 条件に合うitemsだけ残す | Filter |
| itemsを並べ替える | Sort |
| 配列とitemsを変換する | Aggregate/Split Out |
| parameterへ短い動的値を入れる | Expression |
| 独自の複雑なJSON再構成 | Code node |
| 複数itemsを使う独自アルゴリズム | Code node |
| APIへ認証付きrequestを送る | HTTP Request |
同じ結果を標準nodeとCode nodeの両方で作れるなら、次を比較します。
- 処理の意図を画面から読み取れるか
- INPUT/OUTPUTを段階ごとに確認できるか
- 変更する人がコードを保守できるか
- 型や欠損値をどこで検証するか
- エラー時にどこまで原因を絞れるか
- 外部libraryや実行環境へ依存しないか
Code nodeを選んだ場合は、node名に処理目的を付け、巨大な処理を1つへ詰め込まないようにします。
Code - Normalize Sensor Records
Code - Calculate Alert Score
よくある失敗
jsonの形式が正しくない
jsonにはobjectが必要です。配列を返したい場合は、配列を特定fieldの値にするか、配列要素を複数itemsへ変換します。
全itemsモードで1 itemだけ見ている
Run Once for All Itemsでは入力は複数件です。先頭だけを使う処理なのか、全件を処理するのかを明示します。
欠損fieldを前提に計算する
すべてのitemにpressure_mpaが存在するとは限りません。実務では型と欠損時の扱いを決め、必要なら前段のFilterやIFで分けます。
item linkingを設定せずに件数を変える
Code node自体の出力が正しく見えても、後続nodeから前段データを参照すると対応関係が曖昧になることがあります。入力と出力の関係を確認します。
Cloudでmoduleを自由にimportできると思う
CloudのCode nodeでは、任意のnpm moduleやPython libraryを追加できません。self-hostedでも、導入と許可設定なしには使えません。
CodeからcredentialやAPIへ直接アクセスしようとする
CredentialsはCode nodeから取得できません。API通信はHTTP Request nodeへ分離し、Code nodeは受け取ったデータの計算や変換へ責務を限定します。
実務での考え方
Code nodeを使うときは、小さな関数のように入出力を定義します。
input:
  item_count: many
  required_fields:
    - name
    - pressure_mpa

output:
  item_count: same_as_input
  added_fields:
    - pressure_kpa
  item_linking: one_to_one
必要field、欠損時の扱い、入力と出力の件数、item linking、想定する型を明確にすると、コードが短くても安全性が上がります。
長いCode nodeになったら、標準nodeへ戻せる部分がないか、責務を分けるべきか、共通処理としてSub-workflow化すべきかを検討します。Code nodeは「何でもできる箱」ではなく、Workflowの中で境界を決めた小さな処理として使うのが基本です。
今日の実習で確認すること
- 3件程度のitemsをCode nodeへ入力する
- Run Once for All Itemsで10行前後のfield変換を作る
- JavaScriptまたはPythonでn8nのitems形式を返す
- INPUT/OUTPUTのitem数とJSONを比較する
pairedItemと入力indexの対応を確認する- 同じ処理をEdit FieldsとExpressionでも作る
- 標準node版とCode node版の読みやすさ、確認しやすさを比較する
実習結果には、実際に使った言語、コード、入力・出力JSON、item数、item linking、標準nodeで代替できた範囲、実環境のUI差分を記録します。
まとめ
Code nodeは、標準nodeやExpressionでは表現しにくい独自処理を、JavaScriptまたはPythonで追加するためのnodeです。
標準nodeで表現できるか確認
→ 必要ならCode nodeを選ぶ
→ 実行モードを決める
→ items形式で入力を読む
→ items形式とitem linkingを保って返す
→ INPUT/OUTPUTを確認する
JavaScriptとnative Pythonでは、入力変数、built-in methods、libraryの利用範囲が異なります。とくにCloudとself-hostedの差、Pythonの制約は、現在の公式仕様で確認してください。
重要なのはコードを書けたことではなく、なぜ標準nodeではなくCode nodeを選んだのか、入力itemsがどのような出力itemsへ変わったのかを説明できることです。