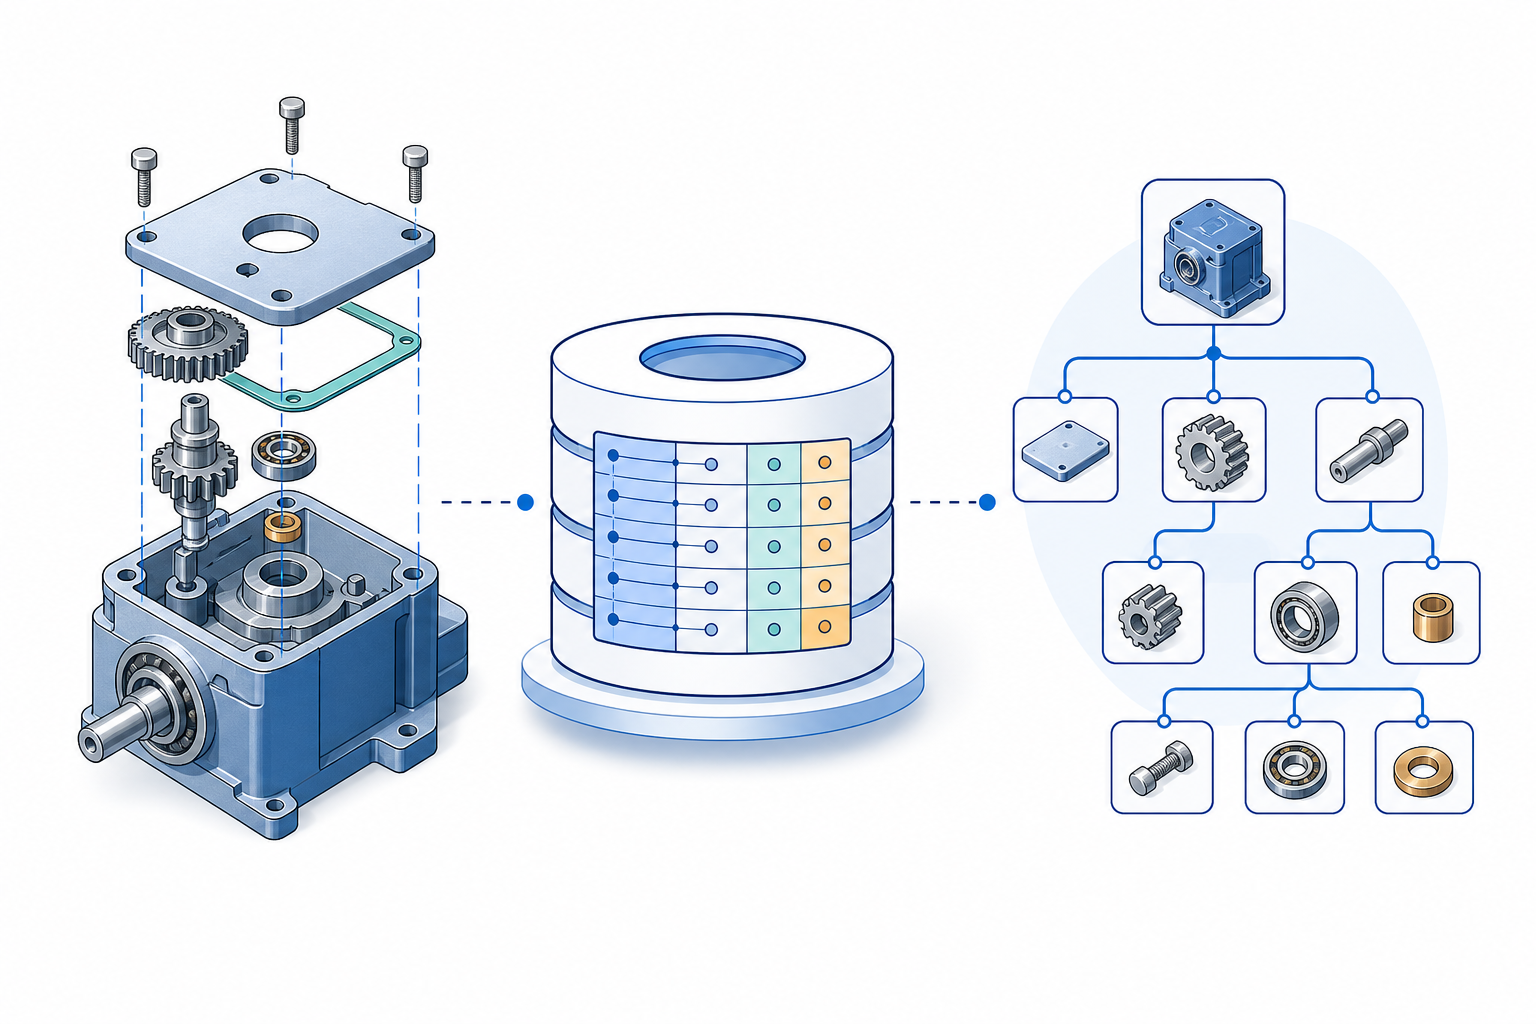
BOM(Bill of Materials、部品表)は、単なる部品一覧ではありません。完成品の下に組立品があり、その下に部品があるという親子関係と、各階層で必要な数量を表す構造です。
Excelの見た目をそのまま一つのtableへ保存すると、同じ部品名が何度も現れ、revision更新、合計数量の計算、CADやAPIとの同期が難しくなります。この記事では、部品マスターとBOMの親子関係を分離し、SQLite、JSON、CSV、Pythonで再利用できるデータ契約を組み立てます。
BOMで分けるべき3種類のデータ
BOMには少なくとも、次の3種類のデータがあります。
- 部品:品番、名称、単位など、その部品自体の属性
- BOM revision:どの構成の、どの版かを示す情報
- 構成行:どの親が、どの子を、いくつ使用するかという関係
最小のJSONは次のように表せます。
{
  "bom_id": "bom-pump-unit",
  "revision": "C",
  "root_item_id": "item-pump-unit",
  "status": "released",
  "lines": [
    {
      "line_no": 10,
      "parent_item_id": "item-pump-unit",
      "child_item_id": "item-motor",
      "quantity": 1
    },
    {
      "line_no": 20,
      "parent_item_id": "item-pump-unit",
      "child_item_id": "item-bolt-m8",
      "quantity": 4
    }
  ]
}全体はobject、linesはobjectのarrayです。parent_item_idとchild_item_idは部品を参照し、quantityはその親1個あたりの使用数を表します。line_noは表示順であり、部品の識別子ではありません。
入れ子JSONだけを正本にしない
画面表示では、BOMを入れ子にすると理解しやすくなります。
{
  "part_number": "ASSY-001",
  "children": [
    {
      "part_number": "SUB-010",
      "quantity": 2,
      "children": []
    }
  ]
}
しかし、この形だけを正本にすると、同じ子部品が複数の組立品で使われるたびに属性が複製されます。名称変更の反映漏れや、同じ品番なのに異なる名称を持つ矛盾が起こりやすくなります。
DBでは、部品をnode、構成行をedgeとして分けます。入れ子JSONは、保存形式そのものではなく、DBから生成する出力形式として扱うと安定します。
SQLiteで部品と親子関係を分離する
次は、整数個の部品を扱う最小構成です。
PRAGMA foreign_keys = ON;

CREATE TABLE items (
    item_id     TEXT PRIMARY KEY NOT NULL,
    part_number TEXT UNIQUE NOT NULL,
    name        TEXT NOT NULL CHECK (length(trim(name)) > 0),
    base_unit   TEXT NOT NULL
);

CREATE TABLE bom_revisions (
    bom_id       TEXT NOT NULL,
    revision     TEXT NOT NULL,
    root_item_id TEXT NOT NULL,
    status       TEXT NOT NULL
        CHECK (status IN ('draft', 'released', 'obsolete')),
    released_at  TEXT,
    PRIMARY KEY (bom_id, revision),
    FOREIGN KEY (root_item_id) REFERENCES items(item_id)
        ON DELETE RESTRICT
);

CREATE TABLE bom_lines (
    bom_id         TEXT NOT NULL,
    revision       TEXT NOT NULL,
    line_no        INTEGER NOT NULL CHECK (line_no > 0),
    parent_item_id TEXT NOT NULL,
    child_item_id  TEXT NOT NULL,
    quantity       INTEGER NOT NULL CHECK (quantity > 0),
    PRIMARY KEY (bom_id, revision, line_no),
    FOREIGN KEY (bom_id, revision)
        REFERENCES bom_revisions(bom_id, revision)
        ON DELETE CASCADE,
    FOREIGN KEY (parent_item_id) REFERENCES items(item_id)
        ON DELETE RESTRICT,
    FOREIGN KEY (child_item_id) REFERENCES items(item_id)
        ON DELETE RESTRICT,
    CHECK (parent_item_id <> child_item_id)
);

CREATE INDEX idx_bom_lines_parent
    ON bom_lines (bom_id, revision, parent_item_id);
PRIMARY KEYは行の一意性、FOREIGN KEYは参照先の存在、CHECKは正の数量や直接の自己参照を検証します。SQLiteの外部キー仕様では、外部キーは参照先が存在する関係を強制します。
SQLiteでは外部キー制約を接続ごとに有効化する必要があるため、接続直後にPRAGMA foreign_keys = ONを実行し、PRAGMA foreign_keysが1を返すことも確認します。宣言を書いただけで有効だと仮定してはいけません。
数量と単位の契約を決める
上の例は、ボルト4本のような整数個を対象にしています。接着剤0.25 kgやケーブル1.5 mを扱う場合は、quantityを浮動小数点へ変えるだけでは不十分です。
- 数量を整数、固定小数、十進文字列のどれで渡すか
base_unitと構成行の単位をどう対応させるか- 丸め桁と許容差をどこで決めるか
- 0、負数、
nullを許可するか
小数を正確に扱う必要があるなら、最小単位へ整数化するか、十進文字列をPythonのDecimalで検証します。数量の型と単位は、CSVとAPIでも同じ契約にします。
revisionを上書きしない
部品のrevisionとBOM全体のrevisionは別の概念です。さらに、図面revisionとBOM revisionが常に同じとは限りません。各fieldが何の版を示すかを命名とデータ辞書で固定します。
公開済みのBOMを直接上書きすると、過去に製造した構成を再現できなくなります。実務では次の流れが安全です。
released revisionを参照
  → 新しいdraft revisionを作成
  → 行を追加・変更・削除
  → 構造と循環参照を検証
  → 承認後にreleasedへ変更
→ 旧revisionは読取専用で保持変更日時だけで版を表さず、bom_idとrevisionの組み合わせを安定した識別子にします。外部システムのrevisionを受け取る場合は、連携元IDも保持し、同名revisionの衝突を防ぎます。
再帰SQLでBOMを展開する
SQLiteの再帰CTEは、treeやgraphをたどる階層queryに利用できます。次のqueryは、指定したrootから子部品をたどり、累積数量を計算します。
WITH RECURSIVE exploded (
    parent_item_id,
    child_item_id,
    depth,
    cumulative_quantity,
    path
) AS (
    SELECT
        parent_item_id,
        child_item_id,
        1,
        quantity,
        '/' || parent_item_id || '/' || child_item_id || '/'
    FROM bom_lines
    WHERE bom_id = :bom_id
      AND revision = :revision
      AND parent_item_id = :root_item_id

    UNION ALL

    SELECT
        bl.parent_item_id,
        bl.child_item_id,
        e.depth + 1,
        e.cumulative_quantity * bl.quantity,
        e.path || bl.child_item_id || '/'
    FROM exploded AS e
    JOIN bom_lines AS bl
      ON bl.bom_id = :bom_id
     AND bl.revision = :revision
     AND bl.parent_item_id = e.child_item_id
    WHERE instr(e.path, '/' || bl.child_item_id || '/') = 0
)
SELECT
    e.depth,
    i.part_number,
    e.cumulative_quantity
FROM exploded AS e
JOIN items AS i ON i.item_id = e.child_item_id
ORDER BY e.depth, i.part_number;
親で2個使うsubassemblyの中にボルトが4本あるなら、完成品1個あたりのボルトは8本です。累積数量は階層を進むたびに掛け合わせます。
この例では、path内の/item_id/を確認して同じnodeへの再訪を止めます。そのため、item_idには/を許可しない契約が前提です。ただし、queryで停止できることと、BOMが正しいことは別問題です。循環を見つけたら無視せず、登録自体を拒否します。
Pythonで循環参照を検出する
直接のA → AはSQLのCHECKで拒否できますが、A → B → C → Aは一行だけ見ても分かりません。保存前にgraph全体を検証します。
from collections import defaultdict


def validate_acyclic(lines: list[dict]) -> None:
    graph: dict[str, list[str]] = defaultdict(list)

    for line in lines:
        parent = line["parent_item_id"]
        child = line["child_item_id"]
        graph[parent].append(child)

    visiting: set[str] = set()
    visited: set[str] = set()

    def visit(item_id: str) -> None:
        if item_id in visiting:
            raise ValueError(f"BOMに循環参照があります: {item_id}")
        if item_id in visited:
            return

        visiting.add(item_id)
        for child_id in graph[item_id]:
            visit(child_id)
        visiting.remove(item_id)
        visited.add(item_id)

    for item_id in list(graph):
visit(item_id)visitingは現在たどっている経路、visitedは検証済みのnodeです。現在の経路へ再び入ったときだけ循環と判定します。
正常系として多段構成、共通部品、同じ子部品を異なる親が参照する例を用意します。異常系には、未知の部品ID、数量0、重複line、rootへ戻るcycle、到達不能な孤立行、想定以上の深さを含めます。
Pythonで一括取込をtransactionにする
一部の行だけ保存されると、BOMは構成として成立しません。全行を検証してから、一つのtransactionで置き換えます。
import sqlite3


def replace_draft_lines(
    conn: sqlite3.Connection,
    bom_id: str,
    revision: str,
    lines: list[dict],
) -> None:
    validate_acyclic(lines)

    with conn:
        row = conn.execute(
            """
            SELECT status
            FROM bom_revisions
            WHERE bom_id = ? AND revision = ?
            """,
            (bom_id, revision),
        ).fetchone()

        if row is None:
            raise ValueError("BOM revisionが存在しません")
        if row[0] != "draft":
            raise ValueError("released revisionは変更できません")

        conn.execute(
            "DELETE FROM bom_lines WHERE bom_id = ? AND revision = ?",
            (bom_id, revision),
        )

        conn.executemany(
            """
            INSERT INTO bom_lines (
                bom_id, revision, line_no,
                parent_item_id, child_item_id, quantity
            ) VALUES (?, ?, ?, ?, ?, ?)
            """,
            [
                (
                    bom_id,
                    revision,
                    line["line_no"],
                    line["parent_item_id"],
                    line["child_item_id"],
                    line["quantity"],
                )
                for line in lines
            ],
)Pythonのsqlite3では、値をSQL文字列へ連結せずplaceholderへ渡します。同じsnapshotを再取込しても、同じdraft revisionの内容へ収束します。途中で制約違反が起きればtransaction全体をrollbackします。
差分更新を受ける場合は、連携元が発行する安定したsource_line_idとsource_systemを保存し、UNIQUE制約とUPSERTを組み合わせます。表示順のline_noだけを重複排除キーにしてはいけません。
CSVとAPIの境界で検証する
CSVでは階層を各行の親子IDで表します。
bom_id,revision,line_no,parent_item_id,child_item_id,quantity
bom-pump-unit,C,10,item-pump-unit,item-motor,1
bom-pump-unit,C,20,item-pump-unit,item-bolt-m8,4取込時は、文字コードとheaderを確認し、IDを文字列、line_noと整数数量を厳密に変換します。空cellをnullや0へ暗黙変換しません。まず一時領域へ全行を読み、次の順で検証します。
構文・文字コード
  → 必須fieldと型
  → IDの存在
  → revisionの更新可否
  → 数量・重複・循環
  → transactionで保存
→ 再帰queryで展開結果を確認APIでも同じ順序を使い、未知のfieldを拒否するか無視するか、最大行数と最大深さ、nullの意味を契約へ記載します。エラーには対象lineと理由を含めますが、内部SQLや機密の部品属性は公開しません。
よくある失敗
- 部品名をIDにする:名称変更で参照が切れます。不変の
item_idと変更可能な名称を分けます。 - 全階層を一つの文字列にする:
ASSY/SUB/PARTは検索や付け替えが難しくなります。親子関係をrowで保存します。 - released版を上書きする:過去の製造構成を再現できません。新しいrevisionを作ります。
- 外部キーを宣言しただけで安心する:SQLiteでは接続ごとの有効化を確認します。
- 再帰queryだけでcycleを処理する:異常データが残ります。保存前のgraph検証で拒否します。
- 数量をすべて浮動小数点にする:精度や単位が曖昧になります。用途に合う型と単位を固定します。
- 親削除を無条件にCASCADEする:影響範囲を誤ると構成が大量に消えます。item masterは
RESTRICTを基本にします。
セキュリティと公開範囲
BOMは製品構造、調達先、原価、製造能力を推測できる機密データです。公開用BOMと社内用BOMを同じresponseへ混在させません。
- 利用者が参照・変更できるbomとrevisionを認可する
- 原価、仕入先、社内備考を構成APIから分離する
- CSVのformula injection対策を表示・出力工程で行う
- SQLはparameter bindingを使う
- 取込file、実行者、schema version、結果を監査記録へ残す
- API keyやtokenをBOM payloadへ含めない
IDが分かることは閲覧権限を持つことと同じではありません。
CAD・API・DBへ再利用する設計
CADから抽出した部品表、ERPの品目マスター、調達システムの発注単位は、同じfield名でも意味が異なる場合があります。連携前に、正本をどのシステムが持つかをfield単位で決めます。
たとえばCADを構成の正本、ERPを品番と調達属性の正本にし、item_id対応表で接続します。変換にはschema_versionとmapping_versionを付け、元snapshotを保持すれば、規則変更後に再生成できます。
部品と関係を分離した構造なら、用途に応じて次の出力を作れます。
- 画面用の入れ子JSON
- 製造用の階層BOM
- 調達用の数量集計BOM
- CSV交換用の親子行
- APIで返すrevision指定snapshot
- RAGや検索用の部品・関係metadata
保存モデルと表示形式を分けることが、BOMを長期的な設計データ資産にします。
まとめ
BOM連携では、表の列をそろえるだけでなく、部品、版、親子関係の役割を分離する必要があります。
- 部品属性は
items、版はbom_revisions、関係はbom_linesへ分ける - 親子は安定したIDで参照し、名称や行番号を識別子にしない
PRIMARY KEY、FOREIGN KEY、CHECKでDB境界を守る- SQLiteでは外部キー制約を接続ごとに有効化する
- released revisionを上書きせず、新しい版を作る
- 再帰CTEで階層と累積数量を展開する
- 多段cycleは保存前にgraph全体で検出する
- snapshot取込を一つのtransactionにし、再実行可能にする
- 数量型、単位、NULL、最大深さ、公開範囲を契約に含める
この設計なら、BOMをExcelの見た目から切り離し、CAD、CSV、API、DB、Pythonの間で検証・再計算できる構造として再利用できます。