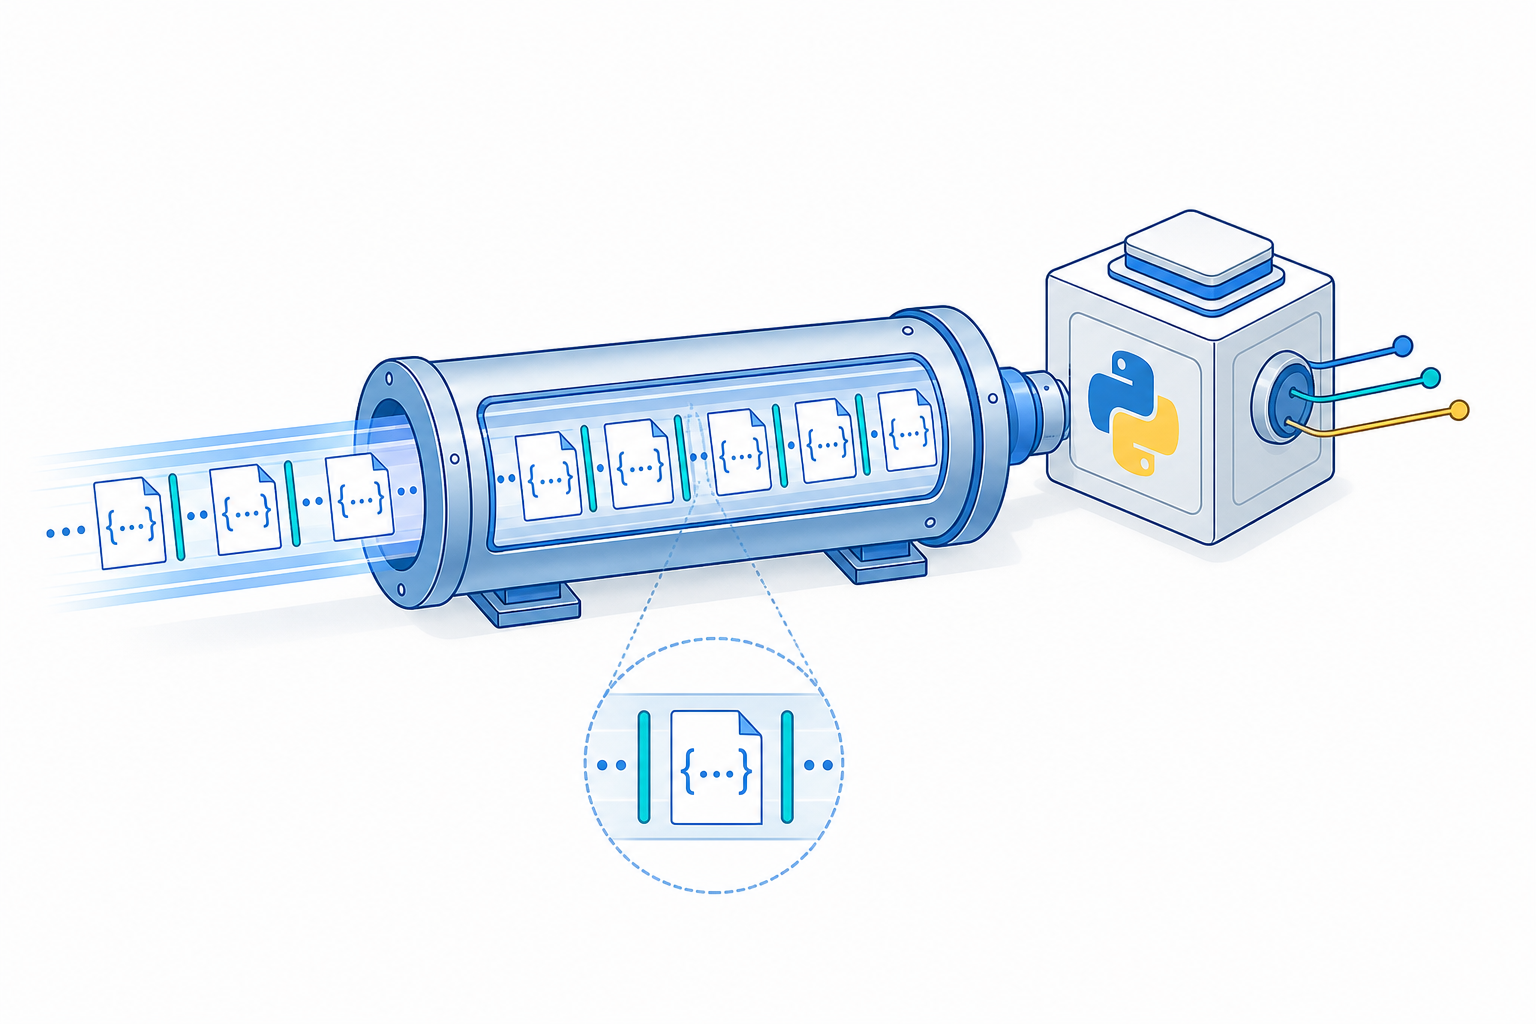
大量のレコードをJSONで受け渡すとき、全件を一つの巨大なarrayへ入れると、送信側も受信側も終端まで待ち、大きなmemoryを確保しがちです。途中で通信が切れれば、どこまで正常だったかも判断しにくくなります。
RFC 7464のJSON Text Sequencesは、独立したJSON textを連続して送るための形式です。各recordを順次生成・検証・保存できるため、計測値、ログ、部品属性、CAD抽出結果のような件数が増えるデータに向きます。ただし、改行区切りJSONと同じものとして扱わず、byte単位の契約と再実行設計を先に決める必要があります。
巨大なJSON arrayで起きる問題
通常のJSONで複数recordを表す基本形はarrayです。
[
  {"record_id": "rec-001", "value": 12.5},
  {"record_id": "rec-002", "value": 13.1}
]
件数が少なければ明快です。一方、長時間続くsensor dataや大規模なexportでは、次の問題が出ます。
- array全体を完成させるまで送信を開始しにくい
- parserが全体をmemoryへ展開する実装になりやすい
- 終端の
]が欠けると文書全体が不正になる - 途中の1recordだけを隔離して後続処理を続けにくい
- 再送時に全件をやり直し、重複登録しやすい
RFC 7464は、長さが確定しない、または終わらないJSON値の列を、通常のstreaming parserなしで逐次処理するためJSON Text Sequencesを定義しています。
JSON Text Sequencesのbyte構造
media typeはapplication/json-seqです。各要素は次の3部分で構成します。
RS + UTF-8で符号化したJSON text + LFRS:ASCII Record Separator、byte値0x1EJSON text:1件分の独立したJSON valueLF:Line Feed、byte値0x0A
説明用に制御文字を<RS>と<LF>で表すと、2件のsequenceは次のようになります。
<RS>{"record_id":"rec-001","value":12.5}<LF>
<RS>{"record_id":"rec-002","value":13.1}<LF>実際のdataに<RS>という5文字を保存するわけではありません。先頭には1byteの0x1E、末尾には1byteの0x0Aを置きます。
RFC 7464は文字コードをUTF-8に限定しています。UTF-16、UTF-32、locale依存の文字コードを混在させません。Content-Typeだけでなく、実際のbyte列も検証します。
RSとLFには別の役割がある
RSは次のrecordの開始位置を明確にします。JSON string内のU+001Eはescapeが必要なので、正しいJSON textの途中に生の0x1Eは現れません。そのため、受信側は次のRSまで読み飛ばして後続recordへ復帰できます。
LFは単なる見やすさのためではありません。top-levelがnumber、true、false、nullの場合、途中で切れた値と完成した値をRSだけでは区別できないことがあります。RFC 7464は、encoderが各JSON textの後ろへLFを付け、parserが空白による終端を確認できるようにしています。
たとえば<RS>123<RS>は、値123が完成していたのか、本来1234になる途中で切れたのか判断できません。<RS>123<LF><RS>なら終端を確認できます。
1recordを独立したobjectにする
JSON text自体はobject、array、string、number、boolean、nullのいずれにもできます。ただし業務連携では、識別子とschema versionを持つobjectへ統一すると検証しやすくなります。
{
  "record_id": "measure-20261005-0001",
  "schema_version": 1,
  "record_type": "measurement.recorded",
  "occurred_at": "2026-10-05T01:20:00Z",
  "data": {
    "asset_id": "pump-042",
    "pressure_mpa": 14.2,
    "enabled": true,
    "note": null
  }
}このrecordでは、全体がobject、record_idなどがkey、右側がvalueです。schema_versionはinteger、record_typeはstring、dataは入れ子のobjectです。複数recordをJSON arrayへ入れず、各objectをsequenceの1要素として並べます。
最低限の契約は次のように整理できます。
| field | type | 必須 | 役割 |
|---|---|---|---|
record_id | string | 必須 | 再送を判定する不変ID |
schema_version | integer | 必須 | record構造の版 |
record_type | string | 必須 | 処理とschemaの選択 |
occurred_at | string | 必須 | 発生日時。形式とtimezoneを別途固定 |
data | object | 必須 | 業務data本体 |
record番号は通信上の位置であり、業務IDではありません。欠落や途中切断があり得るため、「n件目」を同一性の根拠にせず、安定したrecord_idを持たせます。
入力から保存までを段階に分ける
受信処理は、次の責務へ分けます。
application/json-seqを受信
  ↓
RSでrecord境界を検出
  ↓
LF終端・最大byte数・UTF-8を検証
  ↓
各JSON textをparse
  ↓
object構造・field・型・schema versionを検証
  ↓
record_idで重複排除して保存
  ↓
成功位置をcheckpointへ反映
transportの構文検証と業務検証を混ぜないことが重要です。「UTF-8として読めない」「JSONが壊れている」「JSONは正しいがasset_idが存在しない」は、別のerror codeとして記録します。
Pythonで1recordをencodeする
Python標準json moduleで、1件ずつbyte列へ変換できます。
import json


RS = b"\x1e"
LF = b"\n"


def encode_record(record: dict) -> bytes:
    text = json.dumps(
        record,
        ensure_ascii=False,
        separators=(",", ":"),
        allow_nan=False,
    )
return RS + text.encode("utf-8") + LFensure_ascii=Falseでも、JSONでescapeが必要な制御文字はescapeされます。allow_nan=Falseは、RFC 8259で許可されないNaN、Infinity、-Infinityの出力を拒否します。Pythonのdefaultはこれらを出力し得るため、交換仕様に合わせて明示します。
複数件は巨大なlistへまとめず、iteratorから順番に書き込みます。
def write_sequence(stream, records) -> None:
    for record in records:
stream.write(encode_record(record))streamはbinary modeのfileやHTTP response bodyへ接続できます。書き込み途中の失敗を考慮し、送信済み判定をmemory上のcounterだけへ依存させません。
Pythonで壊れたrecordを隔離しながら読む
次の例はchunk単位で読み、RSを境界としてframeを切り出します。1recordの上限も設けます。
import json
from typing import BinaryIO, Iterator


RS_BYTE = 0x1E
LF = b"\n"


def iter_frames(
    stream: BinaryIO,
    *,
    chunk_size: int = 8192,
    max_record_bytes: int = 1_000_000,
) -> Iterator[tuple[int, bytes | None]]:
    record_number = 0
    frame: bytearray | None = None
    too_large = False

    while chunk := stream.read(chunk_size):
        for byte in chunk:
            if byte == RS_BYTE:
                if frame is not None:
                    yield record_number, None if too_large else bytes(frame)
                record_number += 1
                frame = bytearray()
                too_large = False
                continue

            if frame is None or too_large:
                continue

            frame.append(byte)
            if len(frame) > max_record_bytes:
                too_large = True
                frame.clear()

    if frame is not None:
yield record_number, None if too_large else bytes(frame)Noneは上限超過recordを表します。次のRSが来れば、その後のrecord処理を継続できます。frameをJSONへ変換する処理も、成功と失敗を同じ構造で返します。
def reject_constant(value: str):
    raise ValueError(f"JSONで許可されない数値です: {value}")


def unique_object(pairs):
    result = {}
    for key, value in pairs:
        if key in result:
            raise ValueError(f"重複keyです: {key}")
        result[key] = value
    return result


def decode_frame(record_number: int, frame: bytes | None) -> dict:
    if frame is None:
        return {
            "record_number": record_number,
            "ok": False,
            "error_code": "record_too_large",
        }

    if not frame.endswith(LF):
        return {
            "record_number": record_number,
            "ok": False,
            "error_code": "truncated_record",
        }

    try:
        text = frame[:-1].decode("utf-8", errors="strict")
        value = json.loads(
            text,
            parse_constant=reject_constant,
            object_pairs_hook=unique_object,
        )
    except (UnicodeDecodeError, json.JSONDecodeError, ValueError) as exc:
        return {
            "record_number": record_number,
            "ok": False,
            "error_code": "invalid_json",
            "message": str(exc),
        }

    if not isinstance(value, dict):
        return {
            "record_number": record_number,
            "ok": False,
            "error_code": "object_required",
        }

    return {
        "record_number": record_number,
        "ok": True,
        "value": value,
}Pythonのjson.loads()はdefaultでは重複keyの最後の値を採用し、NaNなども受け付けます。この例ではobject_pairs_hookとparse_constantを使い、曖昧な入力を境界で拒否します。
schema検証で正常系と異常系を分ける
JSONとしてparseできても、業務recordとして有効とは限りません。最低限、次を確認します。
- top-levelがobjectである
- 必須fieldがすべて存在する
record_idが空でないstringであるschema_versionがbooleanではなくintegerであるrecord_typeがallowlist内にあるoccurred_atが契約した日時形式に合うdataがobjectであり、type別schemaを満たす- 未知fieldを拒否するか保持するかが決まっている
代表的なtest caseは次のとおりです。
| case | 判定 | 理由 |
|---|---|---|
| 正しいRS・UTF-8・JSON・LF | 正常 | transportとschemaの両方を満たす |
| RSはあるが末尾LFがない | 異常 | 途中切断の可能性がある |
| UTF-8としてdecode不能 | 異常 | RFC 7464の符号化条件に違反 |
| JSON object内に同名key | 異常 | parser間で結果が変わり得る |
schema_versionが未対応 | 隔離 | 将来版を誤って処理しない |
noteがnull | 契約次第 | 欠損、解除、不明の意味をschemaで定義 |
enabledが文字列"false" | 異常 | booleanへ暗黙変換しない |
正常recordだけを保存し、異常recordにはstream_id、record_number、error_code、検出日時を付けます。raw payloadを保存する場合は機密情報と容量を確認し、一般logへ無制限に出力しません。
冪等性とcheckpointを別に設計する
streamの接続が切れると、送信側は先頭または直前のcheckpointから再送することがあります。同じrecord_idが再び届く前提で、DBに一意制約を置きます。
CREATE TABLE ingested_records (
    record_id       TEXT PRIMARY KEY NOT NULL,
    schema_version  INTEGER NOT NULL,
    record_type     TEXT NOT NULL,
    occurred_at     TEXT NOT NULL,
    payload_json    TEXT NOT NULL,
    received_at     TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP
);登録時はrecord_idの衝突を重複として扱い、既存値を無条件に上書きしません。同じIDでpayloadが異なる場合は、単なる再送ではなくID衝突として隔離します。
checkpointは「何件読んだか」ではなく、「どこまで永続化が完了したか」を表します。DB commit前にcheckpointを進めると、障害時に未保存recordを飛ばします。保存後にcheckpoint更新が失敗すれば再送が起きますが、record_idによる重複排除で同じ結果へ収束させられます。
改行区切りJSONと混同しない
1行に1JSONを置く形式も広く使われますが、JSON Text Sequencesとは区切り契約が異なります。RFC 7464ではrecord開始をRSで示すため、JSON text自体に整形用改行を含めても境界を識別できます。
受信側がreadline()だけで処理すると、pretty-printされたobjectを複数recordへ誤分割します。次をinterface仕様へ明記します。
- media typeは
application/json-seq - record開始は
0x1E - record終端は
0x0A - 文字コードはUTF-8のみ
- top-levelはobjectへ限定するか
- 最大record byte数と最大nesting
- error recordを継続するかstream全体を中止するか
「JSONを連続で送る」だけでは、相互運用可能な契約になりません。
セキュリティと完全性
JSON Text Sequences自体は暗号化、署名、改ざん検知を提供しません。HTTPS、認証、認可、必要ならmessage単位またはstream全体の署名を別に設計します。
受信dataは信頼せず、次の制限を設けます。
- stream全体と1recordのbyte上限
- object・arrayのnesting上限
- string、array、integerの長さ・範囲
- 許可するrecord typeとschema version
- timeout、rate limit、同時接続数
- error messageへpayloadやcredentialを出さない規則
RFC 7464は、再parse・再encodeで末尾LFの状態などが変わり、署名検証へ影響し得ることも注意しています。署名対象を「受信した元byte列」にするのか、「正規化済みJSON」にするのかを固定し、途中で表現を変えません。
DB・API・CADへ再利用する設計
JSON Text Sequencesは、recordごとに独立して処理できる点が設計data連携にも合います。
- CAD fileから抽出したentity属性を1recordずつ送る
- BOMの部品・親子関係をtype別recordとしてexportする
- 計測装置の値を長時間streamする
- DBの大量exportを一定件数ずつ生成する
- 検証済みrecordをqueueやobject storageへ中継する
共通envelopeにrecord_id、record_type、schema_versionを持たせ、dataだけを用途別schemaへ分ければ、transport処理を再利用できます。巨大fileそのものはobject storageへ置き、sequenceにはfile ID、revision、hash、取得先を含める設計も可能です。
まとめ
大量JSONの連携では、JSON arrayを大きくするだけでなく、record境界と再実行をdata契約として設計する必要があります。
- RFC 7464では各JSON textをRSで開始し、LFで終える
- 文字コードはUTF-8に固定する
- recordごとに不変ID、type、schema versionを持たせる
- 壊れたrecordはerrorとして記録し、次のRSから復帰できる
- Pythonでは
allow_nan=False、重複key検出、size上限を明示する - checkpointは永続化後に進め、再送はrecord IDで重複排除する
application/json-seqと改行区切りJSONを混同しない- 暗号化、認証、署名、機密data管理は別の層で設計する
この契約を共通化すれば、API、DB export、計測data、BOM、CAD抽出結果を、全件読込に依存せず安全に処理し、途中失敗後も同じ結果へ収束させられます。