CSVやJSONで測定値を保存すると、14.000が数値なのか文字列なのか、日時がUTCなのか、空欄がNULLなのかを別の仕様書で補う必要があります。読み込み側の推測に任せると、Decimalの桁、timezone、先頭ゼロが失われます。
Apache Parquetはschemaを持つ列指向のfile形式です。設計・測定dataを保存する際に、型、NULL、単位、Decimal、UTC日時を契約として固定し、Pythonで検証してから書き出す方法を整理します。
Parquetが解決すること
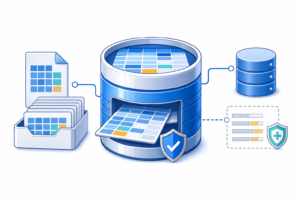
Apache Parquetのfile format仕様では、tableをrow groupへ分け、各row group内にcolumn chunkを配置し、file末尾のmetadataから必要な列の位置を特定する構造が示されています。
列ごとに同じ型の値が並ぶため、encodingやcompressionを適用しやすく、必要な列だけを読む処理にも向きます。さらにschemaへfield名、型、NULL許可を保持できます。
ただしParquetはDBではありません。1行ずつの更新、transaction、一意制約、外部キーをfile単体が提供するわけではありません。分析用snapshot、履歴batch、変換後dataの交換に使い、更新の正本とは役割を分けます。
table・row group・columnの関係
測定dataを次のtableで表します。
| field | type | nullable | 意味 |
|---|---|---|---|
| measurement_id | string | no | 測定recordの一意ID |
| asset_id | string | no | 対象設備のID |
| measured_at | timestamp microsecond UTC | no | 測定時刻 |
| pressure_pa | int64 | no | Paへ正規化した圧力 |
| calibration_factor | decimal(10,6) | no | 校正係数 |
| valid | boolean | no | 有効な測定か |
| note | string | yes | 任意の注記 |
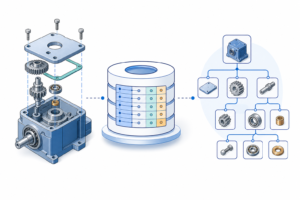
Parquet fileはrecordをrow groupへ分割し、row group内ではfieldごとの値をcolumn chunkとして保持します。読み手はmetadataから必要なcolumn chunkを選べます。
最小dataを型付きで表す
人が確認するためJSON風に書くと、1 recordは次の形です。
{
  "measurement_id": "m-000184",
  "asset_id": "pump-042",
  "measured_at": "2026-10-08T03:15:20.123456Z",
  "pressure_pa": 14000000,
  "calibration_factor": "1.002500",
  "valid": true,
  "note": null
}これは説明用の表現です。文字列"1.002500"はDecimalへ、日時文字列はtimezone付きtimestampへ変換してから保存します。同じdatasetで単位を固定できるなら、pressure_paのfield名とschema metadataで基準単位を示します。入力単位が混在する場合は、元値・元単位と正規化値を別fieldにします。
物理型と論理型を区別する
Parquetは保存に使うprimitive typeへ、意味を表すlogical typeを付けられます。Parquet Logical Typesでは文字列、Decimal、日時などの解釈が定義されています。
Decimalは整数のunscaledValueとscaleから値を表します。decimal(10,6)なら最大10桁、うち小数点以下6桁です。PythonのDecimalから渡せば十進桁を保てます。
timestampでは精度とtimezoneを決めます。ここではtimestamp("us", tz="UTC")とします。local timeだけでは同じ09:00の地域を確定できないため、入力境界でtimezone-awareな日時だけを受け付け、UTCへ正規化します。
PyArrowでschemaを先に定義する
dataから型を推測させず、先にschemaを定義します。Apache Arrowのdata type APIでは、Fieldが名前、data type、nullability、任意metadataを持ち、Schemaがfieldの集合を表します。
from datetime import datetime, timezone
from decimal import Decimal
from pathlib import Path

import pyarrow as pa
import pyarrow.parquet as pq


SCHEMA = pa.schema(
    [
        pa.field("measurement_id", pa.string(), nullable=False),
        pa.field("asset_id", pa.string(), nullable=False),
        pa.field("measured_at", pa.timestamp("us", tz="UTC"), nullable=False),
        pa.field("pressure_pa", pa.int64(), nullable=False),
        pa.field("calibration_factor", pa.decimal128(10, 6), nullable=False),
        pa.field("valid", pa.bool_(), nullable=False),
        pa.field("note", pa.string(), nullable=True),
    ],
    metadata={b"schema_version": b"1", b"pressure_unit": b"Pa"},
)


rows = [
    {
        "measurement_id": "m-000184",
        "asset_id": "pump-042",
        "measured_at": datetime(
            2026, 10, 8, 3, 15, 20, 123456, tzinfo=timezone.utc
        ),
        "pressure_pa": 14_000_000,
        "calibration_factor": Decimal("1.002500"),
        "valid": True,
        "note": None,
    }
]

table = pa.Table.from_pylist(rows, schema=SCHEMA)
output = Path("measurements-v1.parquet")
pq.write_table(table, output, compression="zstd")nullable=Falseはschema上の契約ですが、業務dataの完全なvalidationと同じ責務ではありません。書き込み前に必須値、範囲、ID重複を検証します。
入力を検証してから変換する
CSVやAPIの入力は、Arrow Tableへ渡す前に正規化します。最低限、次を確認します。
- IDは空でないstringか、同一batch内で重複していないか
pressure_paはbooleanではなく整数か、業務上の範囲内かcalibration_factorは有限のDecimalか、precision 10・scale 6に収まるかmeasured_atはtimezone付きdatetimeか、UTCへ変換済みかvalidは0や"true"ではなくbooleanかnoteはstringまたはNULLか
Pythonではboolがintのsubclassなので、数値fieldではbooleanを先に除外します。Decimal("NaN")や無限大も生成できるため、is_finite()も確認します。変換不能なrecordは正常dataと混ぜず、行番号、field、理由をerror tableへ保存します。
書いたfileを読み戻して検証する
書き込み成功だけで完了にせず、schemaとmetadataを読み戻します。
parquet_file = pq.ParquetFile("measurements-v1.parquet")
actual_schema = parquet_file.schema_arrow

if not actual_schema.equals(SCHEMA, check_metadata=True):
    raise ValueError("書き出したschemaまたはmetadataが契約と異なります")

selected = pq.read_table(
    "measurements-v1.parquet",
    columns=["measurement_id", "measured_at", "pressure_pa"],
    filters=[("valid", "=", True)],
)PyArrowのwrite_tableはArrow TableをParquetへ書き出し、compression、row group、timestamp変換などを指定できます。store_schema=Trueが既定で、Arrow schemaがfile metadataへ保存されるため、timezoneなどをより忠実に復元できます。read_tableでは列選択とfilterを指定できます。
metadataへversionや単位を入れても、読取側が確認しなければ契約は強制されません。受信処理で期待version、必須field、型、範囲を検証します。
NULL・NaN・欠落fieldを分ける
ParquetのNULLは値が存在しない状態です。浮動小数点のNaNは特殊な数であり、NULLではありません。空文字もstring valueです。
note: null:注記がないnote: "":0文字の注記があるpressure_pa: null:必須測定値が欠落しているため拒否calibration_factor: NaN:有限の係数ではないため拒否- field自体がない:登録契約の必須違反として拒否
NULLを0へ置換すると「未測定」と「0 Pa」を混同します。補完する場合は、元値と補完規則を追跡できるようにします。
schema変更はversionで管理する
新旧fileを同じdatasetとして読むなら変換規則が必要です。NULLを許可したfieldの追加は比較的扱いやすい一方、field名、型、Decimalのscale、単位、timezone、nullabilityの変更は明示的にmigrationします。
新schemaで旧fileを暗黙に読めると仮定せず、schema_versionごとにreaderを用意します。PaからMPaへ変更する場合はfield名だけを再利用せず、旧値を変換して新versionへ書き出します。
再実行と重複をmanifestで管理する
Parquet単体には一意制約がないため、同じbatchの再実行でfileとrecordが重複し得ます。外側のmanifestで管理します。
{
  "dataset": "measurements",
  "schema_version": 1,
  "batch_id": "2026-10-08-pump-042-0001",
  "file_name": "measurements-v1.parquet",
  "record_count": 1,
  "status": "ready"
}- 安定した
batch_idで再実行を識別する - 一時名へ書き、検証後に公開位置へ移す
- manifestへrecord数、schema version、hashを記録する
- 読取側は処理済み
batch_idを保存する - record単位では
measurement_idの重複も検査する
1 recordごとに小さなfileを作るとmetadataとI/Oの比率も増えます。更新頻度と読取patternに合わせてbatchとrow groupを設計します。
セキュリティと公開情報の分離
Parquetはaccess controlではありません。fileを読める利用者は列やmetadataを取得できます。
- credentialを列やmetadataへ入れず、storage側で権限と暗号化を設定する
- 公開datasetから顧客ID、内部path、機密設備情報を除く
- 信頼できないfileではsize、column数、nested構造を制限する
- checksumやhashを認証・認可の代わりにしない
公開用fileは内部用fileから許可列だけを選択して別に生成します。
DB・API・CADへ再利用する
DBの主キーとmeasurement_idを対応させ、API入力を同じ型規則でArrowへ変換します。CAD属性は抽出直後に基準単位へ正規化します。API、DB、Arrow、Parquetでは型と制約の表現が異なるため、境界にmappingを置き、入力file・変換program・出力Parquetのprovenanceも記録します。
まとめ
Parquetは、設計・測定dataを型付きの列として保存し、必要な列を効率よく再利用するための形式です。ただし、file形式だけでdata品質は保証されません。
- field、型、NULL許可、単位を先に定義する
- Decimalのprecisionとscale、日時のtimezoneを固定する
- 書き込み後にschema、metadata、record数を確認する
- versionとmigration規則を用意する
- batch IDとmanifestで再実行と重複を管理する
- credentialや機密metadataを混在させない
この契約を入力validation、PyArrow schema、Parquet file、manifestへ一貫して反映すれば、CSVやJSONから受け取ったdataを、DB、分析基盤、API、CADへ意味を保ったまま再利用できます。