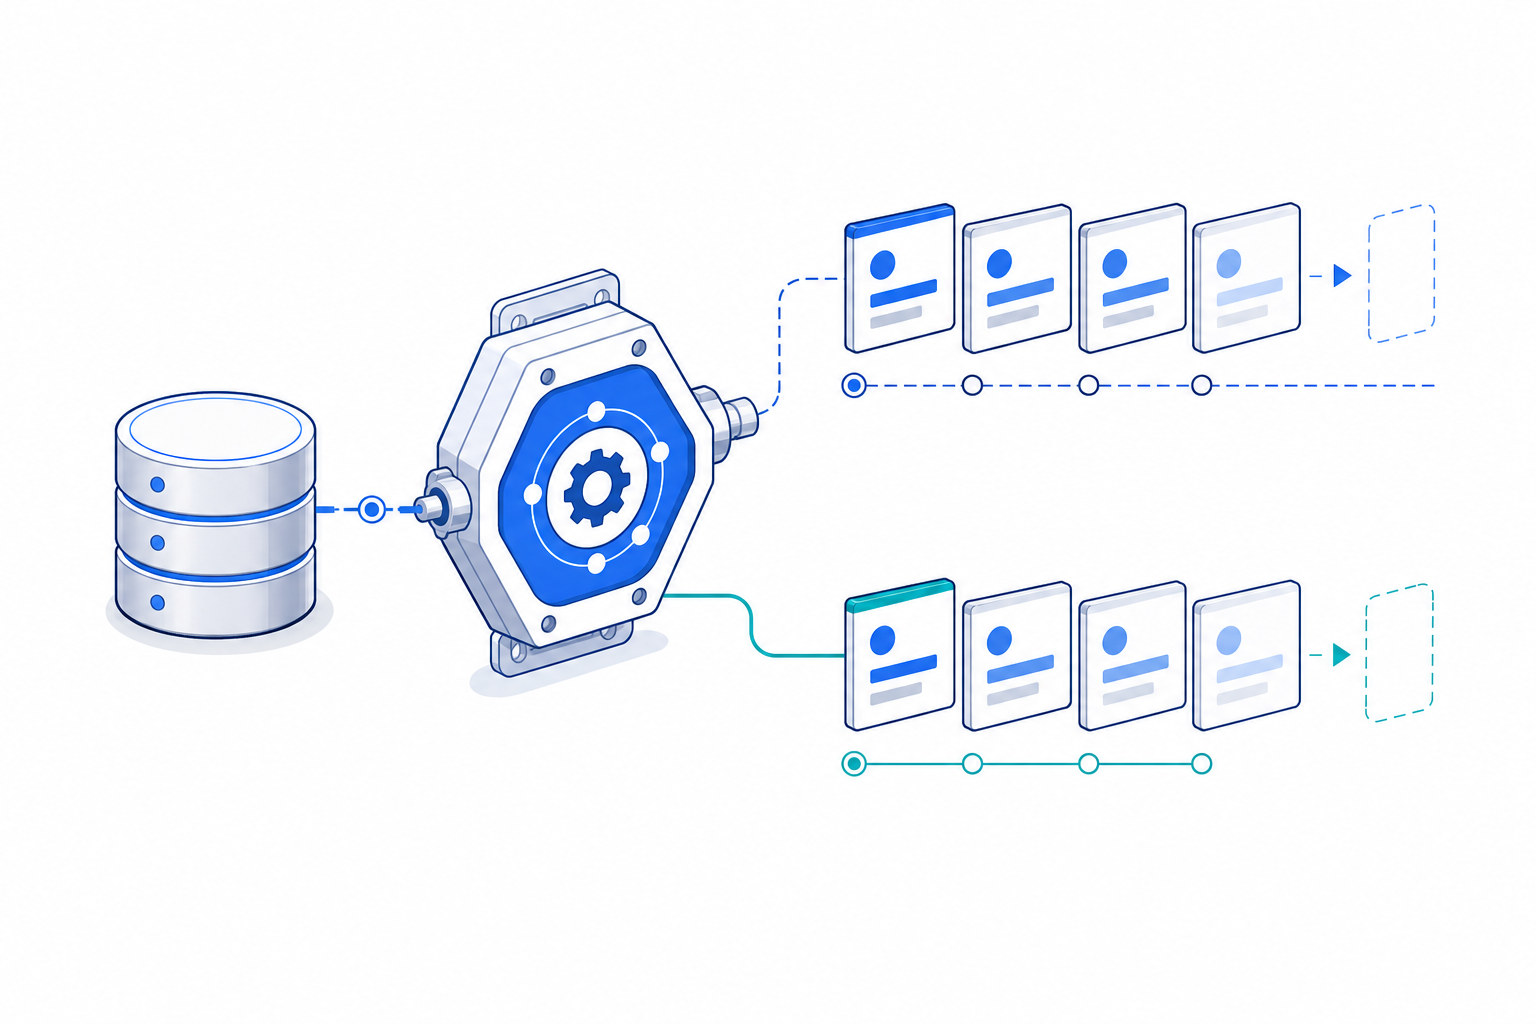
APIから部品、図面、計測結果などを一覧取得するとき、全件を一度に返すと応答が大きくなり、DBとネットワークの負荷も増えます。そこで結果を複数回に分けるページネーションを使います。
しかし、page=2を追加するだけでは十分ではありません。取得中にデータが追加・削除・更新されると、同じrecordが再登場したり、一件も取得されないまま処理が終了したりします。
この記事では、offset方式とcursor方式の違いを整理し、安定した並び順、複合キー、署名付きcursor、再実行時の扱いまでをAPI・SQLite・Pythonで実装できる形にします。
ページネーションで解決すること
ページネーションは、大きなcollectionを一定件数ずつ取得する仕組みです。APIの役割は「何件目から返すか」だけではありません。次の取得位置を、検索条件や並び順と矛盾しない形で引き継ぐ必要があります。
最小のresponseは次のように設計できます。
{
  "items": [
    {
      "id": "asset-0041",
      "created_at": "2026-09-26T01:29:58Z",
      "name": "Pump unit A"
    },
    {
      "id": "asset-0042",
      "created_at": "2026-09-26T01:30:00Z",
      "name": "Pump unit B"
    }
  ],
  "next_cursor": "eyJ2IjoxLC4uLn0.signature"
}itemsはrecordのarray、next_cursorは次回requestで渡す文字列です。最終ページではnext_cursorをnullにする、またはfieldを省略すると契約で決めます。
クライアントは件数がpage_size未満かどうかではなく、この値で終了を判断します。フィルター処理などにより、途中のページが要求件数より少なくなる実装もあるためです。
offset方式で重複と欠落が起きる理由
offset方式は、先頭から何件飛ばすかを指定します。
SELECT id, created_at, name
FROM assets
ORDER BY created_at ASC, id ASC
LIMIT 20 OFFSET 40;
管理画面の小さな固定データや、任意のページ番号へ移動したい画面では分かりやすい方法です。一方、取得中にデータが動く一覧では位置がずれます。
たとえば1ページ目の取得後、先頭に新しいrecordが追加されたとします。2ページ目で同じoffsetを使うと、前ページの末尾が後ろへ押され、再び返る可能性があります。逆に先頭側のrecordが削除されると後続recordが前へ詰まり、offsetより前へ移動した一件を飛ばすことがあります。
性能面でも、SQLite公式資料は、大きなoffsetほど先頭側の値を計算して破棄する処理が増えると説明しています。offset方式が常に誤りなのではなく、更新のある大量データを連続走査する用途と相性が悪いのです。
cursor方式は「最後に読んだ値」を引き継ぐ
cursor方式では件数を数えて飛ばすのではなく、前ページの最後のrecordを基準に、その直後から取得します。DBではkeyset paginationとも呼ばれます。
SELECT id, created_at, name
FROM assets
WHERE (created_at, id) > (?, ?)
ORDER BY created_at ASC, id ASC
LIMIT ?;
SQLiteのrow value比較は左から順に値を比較します。前回末尾のcreated_atとidを渡せば、同じ並び順の続きだけを取得できます。対応するindexも用意します。
CREATE INDEX idx_assets_created_id
ON assets (created_at, id);
cursorの内部データは、たとえば次のようになります。
{
  "v": 1,
  "sort": "created_at,id",
  "created_at": "2026-09-26T01:30:00Z",
  "id": "asset-0042",
  "filter": "status=active"
}v:cursor形式のversionsort:適用した並び順created_atとid:前ページ末尾の複合キーfilter:cursorを発行した検索条件
これをそのまま公開する必要はありません。APIはURLで扱える不透明な文字列へ変換し、クライアントには内部を解釈させません。
並び順には必ず一意なtie-breakerを付ける
ORDER BY created_atだけでは、同じ時刻を持つrecordの順序が確定しません。秒精度の日時なら同時刻は珍しくなく、ページ境界で入れ替わる可能性があります。
そこで、最後に一意で不変なidを追加します。
ORDER BY created_at ASC, id ASCcursor側にも同じ2値を保持し、WHERE (created_at, id) > (?, ?)と比較します。sortに使うcolumnがNULLを許すと比較結果が不定になるため、ページ境界に使うcolumnはNOT NULLにするか、NULLの並びと変換規則を明示します。
文字列の照合順序、日時の形式、大文字・小文字の扱いも、DBとcursor生成処理で一致させます。API契約のsortと実際のSQLが違えば、cursorは正しい位置を示せません。
page_sizeより1件多く取得する
次ページの有無を知るため、DBからpage_size + 1件を取得し、利用者には先頭のpage_size件だけを返します。
要求 page_size = 20
DB取得 LIMIT = 21

21件あった → 20件を返し、20件目からnext_cursorを作る
20件以下 → 全件を返し、next_cursorはnull毎回COUNT(*)で総件数を数える必要がなく、一覧の正確な総数が不要なAPIに向きます。total_countを返す場合は、取得中の増減で表示件数とずれる可能性や、概算か確定値かを仕様へ記載します。
Pythonで署名付きcursorを作る
Base64はbinaryをURL安全な文字列へ変換できますが、暗号化でも改ざん検知でもありません。cursorの位置やfilterを利用者が書き換えられないよう、HMACで署名します。
import base64import hashlibimport hmacimport jsondef b64url_encode(data: bytes) -> str: return base64.urlsafe_b64encode(data).rstrip(b"=").decode("ascii")def b64url_decode(value: str) -> bytes: padding = "=" * (-len(value) % 4) return base64.urlsafe_b64decode(value + padding)def encode_cursor(payload: dict, secret: bytes) -> str: body = json.dumps( payload, ensure_ascii=False, sort_keys=True, separators=(",", ":"), ).encode("utf-8") signature = hmac.new(secret, body, hashlib.sha256).digest() return f"{b64url_encode(body)}.{b64url_encode(signature)}"def decode_cursor(token: str, secret: bytes) -> dict: try: body_text, signature_text = token.split(".", 1) body = b64url_decode(body_text) received = b64url_decode(signature_text) except (ValueError, UnicodeError) as exc: raise ValueError("cursorの形式が不正です") from exc expected = hmac.new(secret, body, hashlib.sha256).digest() if not hmac.compare_digest(expected, received):署名用secretはソースコードやcursorへ含めず、secret管理機能から取得します。鍵を切り替えるならkey_idを管理し、移行期間中に旧鍵を検証できる手順を用意します。
cursorへ機密情報や個人情報を入れてはいけません。署名しても内容はBase64から復元できます。情報を見せられない場合は、サーバー側に状態を保存してランダムtokenだけを返すか、暗号化を含む別の方式を設計します。
SQLiteから次ページを取得する
decodeした値をSQL parameterとして渡し、page_size + 1件を取得します。
import sqlite3def fetch_assets( conn: sqlite3.Connection, *, page_size: int, cursor: dict | None = None,) -> tuple[list[sqlite3.Row], bool]: if not 1 <= page_size <= 100: raise ValueError("page_sizeは1以上100以下です") params: list[object] = [] where = "" if cursor is not None: if cursor.get("sort") != "created_at,id": raise ValueError("cursorのsortが一致しません") where = "WHERE (created_at, id) > (?, ?)" params.extend([cursor["created_at"], cursor["id"]]) params.append(page_size + 1) rows = conn.execute( f""" SELECT id, created_at, name FROM assets {where} ORDER BY created_at ASC, id ASC LIMIT ? """, params, ).fetchall() has_more = len(rows) > page_size return rows[:page_size], has_more動的SQLは固定したwhere断片だけに限定し、cursorの値はparameter bindingで渡します。利用者が指定するsortを許可する場合も、column名と方向をallowlistから選び、入力文字列をSQLへ直接連結しません。
検索条件を途中で変えない
cursorは、発行時と同じfilter、sort、tenant、公開範囲で使う必要があります。1ページ目をstatus=activeで取得し、2ページ目をstatus=archivedへ変えれば、継続位置の意味がなくなります。
Google AIP-158でも、page tokenを使う後続requestではpage_size以外の引数を一致させる考え方が示されています。
実装では次のいずれかを採用します。
- 正規化したfilterとsortをcursorへ含め、requestと比較する
- 検索条件のhashをcursorへ含める
- 検索条件をサーバー側へ保存し、cursorから参照する
不一致、壊れた署名、未対応version、期限切れは、曖昧に先頭ページへ戻さず入力エラーとして返します。先頭へ戻すとクライアントが重複処理に気づけません。
更新中のデータとsnapshot境界
cursor方式でも、取得中にsort key自体が変われば完全なsnapshotにはなりません。updated_atで並べたrecordが更新されると末尾へ移動し、同じIDが再登場することがあります。
用途に応じて次の契約を選びます。
通常の一覧表示
不変のcreated_atとidで並べ、新規recordが後続ページへ現れることを許容します。画面側はIDで重複排除できます。
大量export
開始時点の上限をcreated_at <= snapshot_atのように固定し、すべてのcursorへ引き継ぎます。より強い整合性が必要なら、DBのsnapshotやexport jobを使って結果集合を固定します。
差分同期
updated_atとidをwatermarkにし、同期開始時の上限までを走査します。削除も伝える必要がある場合は、物理削除だけでなくtombstoneや変更履歴を用意します。単なる一覧APIを完全な同期logとして扱わないことが重要です。
cursorを再送したときに同じページを返す必要があるなら、live dataだけでは保証できません。snapshot IDやexport job IDをcursorへ関連付け、同じ結果集合を参照させます。
正常系と異常系をテストする
ページ境界の不具合は、少量の固定データだけでは見つかりません。最低限、次を確認します。
- 同じ
created_atを持つ複数recordがページをまたいでも、ID順で全件を一度ずつ取得できる - ページ間に先頭側へINSERTしても、取得済みrecordが再登場しない
- cursor、filter、sortの組み合わせが違えば拒否される
- cursorの1文字を変えると署名検証に失敗する
page_sizeの0、負数、上限超過を契約どおり処理する- 空のcollectionと最終ページでは
next_cursorがない NULL、不正日時、重複IDをDB制約または入力検証で拒否する
クライアント側も、通信失敗時は直前に成功したcursorから再開し、保存済みIDの重複を許容できるようにします。cursorの保存と取得結果の反映を別々に行う場合は、どちらを先に確定するかで取りこぼしや再処理が変わります。
offsetとcursorを使い分ける
offset方式は、次の用途で実用的です。
- 件数が小さく、更新頻度も低い管理画面
- ページ番号や任意位置への移動が必須
- 一時的な検索結果で、多少の位置ずれを許容できる
cursor方式は、次の用途に向きます。
- 件数が多く、後半まで連続取得するAPI
- 取得中にも追加・削除が起きるcollection
- バッチ、export、差分同期など再開位置が重要な処理
cursor方式は任意のページ番号へ直接飛ぶのが苦手です。UI上の要件がページ番号ならoffsetを選び、連携APIではcursorを選ぶなど、同じDBでも入口ごとに方式を分けられます。
セキュリティと公開範囲
cursorは認可tokenではありません。正しいcursorを持っていても、requestごとに利用者、tenant、resourceの閲覧権限を確認します。
また、次の対策を組み合わせます。
- cursorの長さと
page_sizeへ上限を設ける - cursorをHMACで検証し、改ざん値をDBへ渡さない
- filterとtenantの一致を検証する
- cursorやログへcredential、個人情報、機密条件を残さない
- 不正cursorの詳細な内部値をエラーresponseへ出さない
- 大量走査にはrate limitと適切な認可を設ける
署名は位置情報の完全性を守りますが、閲覧権限や機密性を保証するものではありません。役割を分けて設計します。
CAD・設計データ連携への展開
図面一覧、部品表、属性、計算結果は件数が増えやすく、連携中にも改訂されます。drawing_idやpart_idをtie-breakerにし、revisionや更新日時の意味を契約化すれば、DB、API、Pythonの走査条件を共有できます。
ただし、BOMの親子関係を単純な一覧cursorだけで再現しようとすると、取得途中の構成変更を捉えにくくなります。構成全体にはrevisionまたはsnapshot IDを付け、各ページが同じ版を参照する形が安全です。
cursorの内部schemaにもversionを持たせれば、将来sort keyや保存方式を変更するとき、旧cursorを明示的に拒否するか移行できます。
まとめ
ページネーションは、responseを小さく分けるだけの機能ではありません。変化するcollectionを、どの順序で、どこから再開するかを決めるデータ契約です。
- 小規模でページ番号が必要ならoffset方式を検討する
- 大量の連続取得にはcursor方式を使う
- sort keyには一意で不変なtie-breakerを付ける
- DBではcursorと同じ複合キーを
WHEREとORDER BYへ使う page_size + 1件で次ページの有無を判定する- cursorをURL安全・不透明にし、改ざんを署名で検知する
- filter、sort、tenant、snapshot条件を後続requestでも維持する
- live一覧、export、差分同期で必要な整合性を分ける
- cursorを認可や暗号化の代わりにしない
一覧取得の入口でこの契約を固定すれば、API、SQLite、Python、CADデータ連携を途中から安全に再開でき、重複や欠落を例外ではなく設計上の条件として扱えます。